SYNtzulu:一种用于低功耗 FPGA 实时传感器数据分析的微型 RISC-V 控制 SNN 处理器
文章工作概述
- 本文提出的是一套可重构微型 SNN 整体架构,用一个极小的、时钟驱动(clock-driven)的 FPGA SNN 推理引擎,在低端 iCE40UP5K(5280 LC)上支持事件式时间编码(event-based temporal encoding)的实时近传感时序数据分析,并由一颗位串行 RISC-V(SERV)软核负责 I/O、参数配置与细粒度功耗管理;推理峰值功耗 12.05 mW,配合动态电源管理平均可降到 1.45–9.87 mW(视应用而定),每突触能耗 62 pJ(比同类 FPGA 加速器低约 452×–661×)。
文章贡献
- 借助硬件可配置编码插槽实时执行基于事件的时间编码(见相关概念)算法,从而在 FPGA 上实现面向时序数据的 SNN 分析。
- 在极小的资源开销下,实现突触粒度的脉冲稀疏管理,即使输入为基于事件的时间编码脉冲流,也可在 FPGA 上实现类神经形态计算。
- 通过硬件资源精简与轻量化 SNN 模型相结合,大幅降低功耗,满足深度边缘场景的功耗约束。
- 利用RISC-V 软核实现细粒度功耗管理,适配不同任务时序需求,进一步把脉冲稀疏性转化为功耗节省。
SYNtzulu 的实现方式
整体硬件的核心模块划分:
- 可配置编码插槽(configurable encoding slot) 预处理传感器原始时序信号,生成脉冲序列(spike trains)。
- SNN 引擎(SNN engine),包含两个子处理器 整个架构的主计算核心,负责 SNN 推理运算。
- 可配置解码插槽(configurable decoding slot) 把 SNN 输出的脉冲序列转换成 MCU 或人可读的结果,比如分类标签、回归数值(sEMG 力值、运动跟踪)。
- RISC-V 软核 不负责 SNN 推理,只负责数据流 IO、功耗管理,以及对架构超参数的灵活配置(编码阈值、解码参数等)。
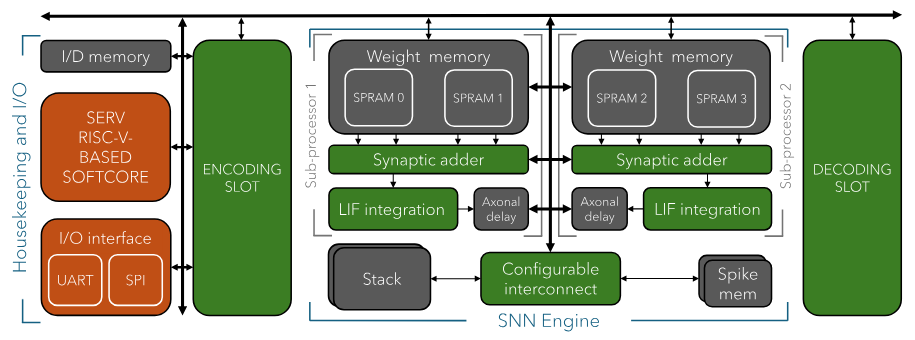
SNN Engine
该部分对应架构图:
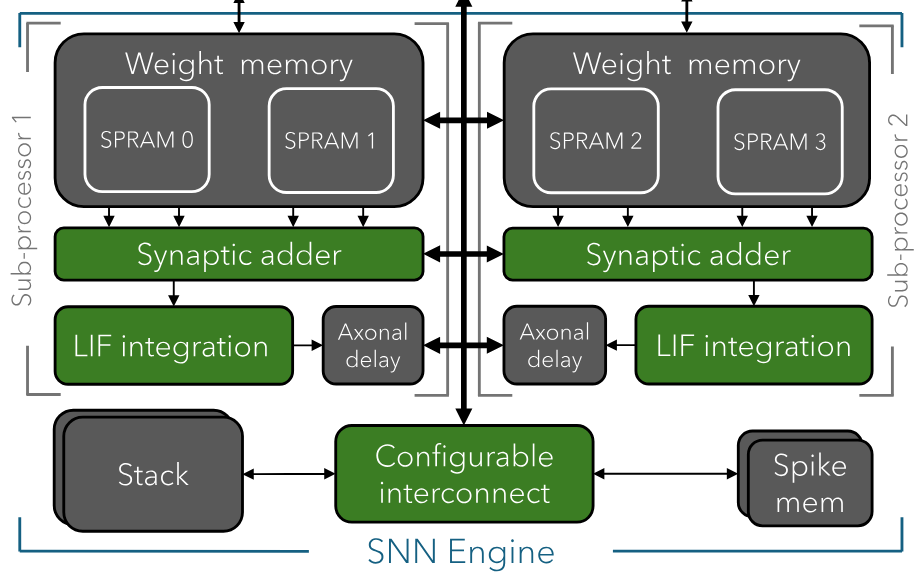
SNN 的计算基于下面的神经元动力学公式,后面的内容全部围绕它展开:
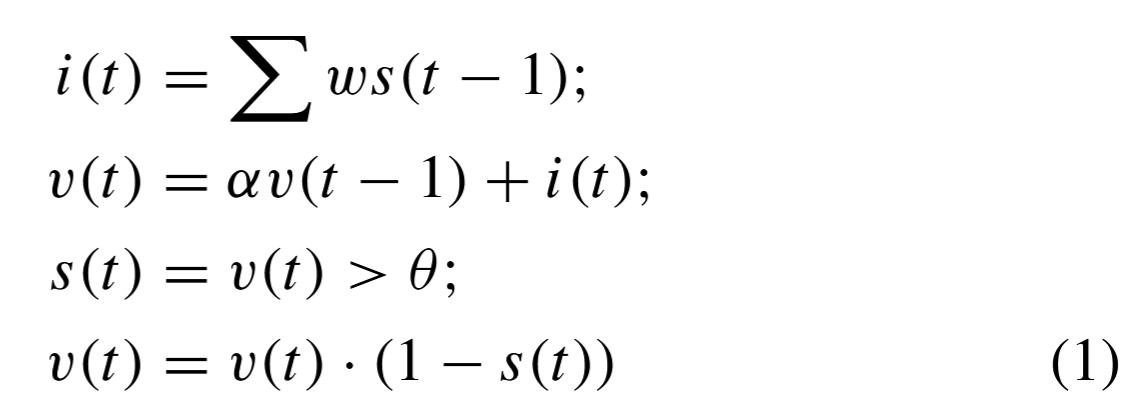
其中,i(t) 是突触电流,w 是突触权重,s(t−1) 是上一时刻的输入脉冲,v(t) 是膜电位,α 是衰减因子,θ 是脉冲阈值。注意第一条用的是上一时刻的脉冲,第四条是发放脉冲后把膜电位按 (1−s) 复位(s=1 时清零)。
weight memory 与 synaptic adder 工作原理
该模块的职责相当于公式的第一条,也是计算量最大、功耗最大的一条
突触电流的求和需要依赖大量权重,而权重需要预加载存储在片上,iCE40UP5K 的片上存储大部分由 4 个 16 位宽的单端口 RAM(SPRAM) 提供,这些块用来存权重。权重是 8 位宽,所以每个 SPRAM 一次能输出两个权重,4 个 SPRAM 合计每周期可同时输出 8 个 8 位权重。
每对 SPRAM 每周期送来 4 个 8 位权重,交给突触加法器累加。整个引擎有 2 个并行子处理器,每个子处理器各嵌入一个 SIMD 并行的突触加法器,以分担推理工作量。
一侧的突触加法器(SIMD-parallel synaptic adder)具体工作流程如下:
|
|
SYNtzulu 有一对并行处理器,因此一次能处理两个神经元;每个处理器单次可并行计算一个神经元的四路输入突触。对网络中的神经元迭代处理,直到所有层都算完。
LIF integration unit 工作原理
该模块的职责相当于公式中的后三条
因此它的任务就是:
- 输入每个神经元的i(t)积分计算结果
- 更新v(t) = αv(t−1) + i(t)
- 当前神经元进行阈值判断并发放脉冲:s(t)=v>θ,然后 v←v(1−s)
spike mem 与 stack 协同存储与脉冲稀疏性原理
每次运算后输出两个神经元的脉冲。SYNtzulu 把脉冲按 4 个一组打包存入 spike mem,再把该组的组号存入 stack。分组的目的是利用脉冲稀疏性(见相关概念):组内脉冲全为 0 时直接丢弃组号,下层就不用再算这一组,从而大幅减少计算量、功耗与推理时间。
存储方式:
- 按顺序将输出的脉冲组编组号,将脉冲组存入spike mem对应组号的地址中
- 同时判断该组是否稀疏:4 位脉冲中只要有任意一位不为 0,就把组号存入 stack;全为 0 则直接丢弃组号。
在下一层计算时,只需要每一个神经元轮询stack中存储的组号,然后从spike mem中读取对应组号的脉冲组,进行计算。
此外,还涉及到一些需要存储的量:
- 膜电位 v(t) :在计算完成后存入到 bram_fifo(每一个处理器有一块)中。
- 末层神经元膜电位 :存入到 output_buffer 中,以供输出。
计算总体预览
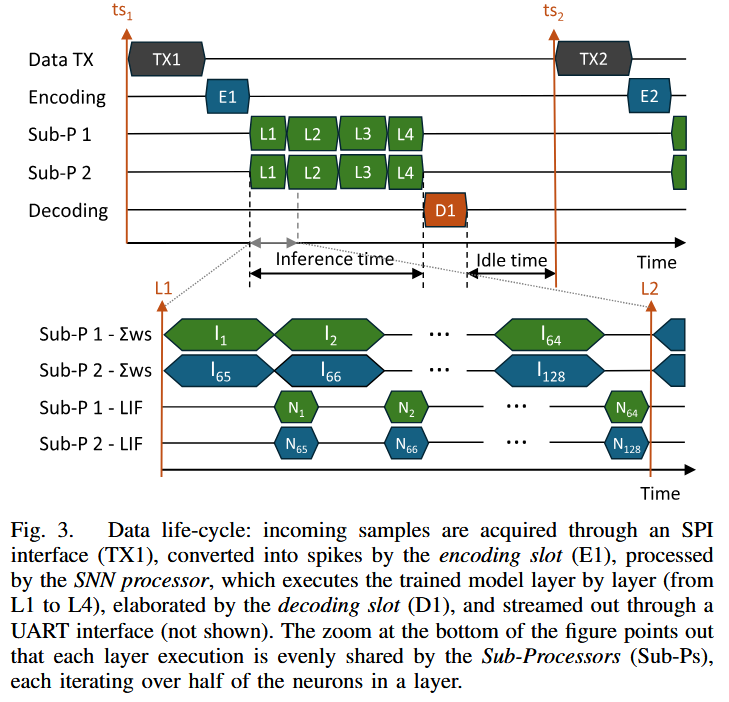
图中显示了 SYNtzulu 执行的处理步骤(上半图绿色部分为 SNN Engine 的执行过程)。首先,通过SPI接口读取传感器数据,然后SNN引擎可以逐层执行推理,均匀地将神经元层的计算分发在两个子处理器上,如图中的缩放所示。最后,将推理结果进行解码并通过UART接口进行传输(未显示)。从图中的放大细节可以看到,神经元积分与同层下一个神经元的突触电流计算是重叠进行的。执行在每个采样时间重复进行;此外,根据工作负载的不同,五个执行阶段(SPI数据传输、编码、推理、解码和 UART 数据传输)可以重叠。
编码/解码模块插槽
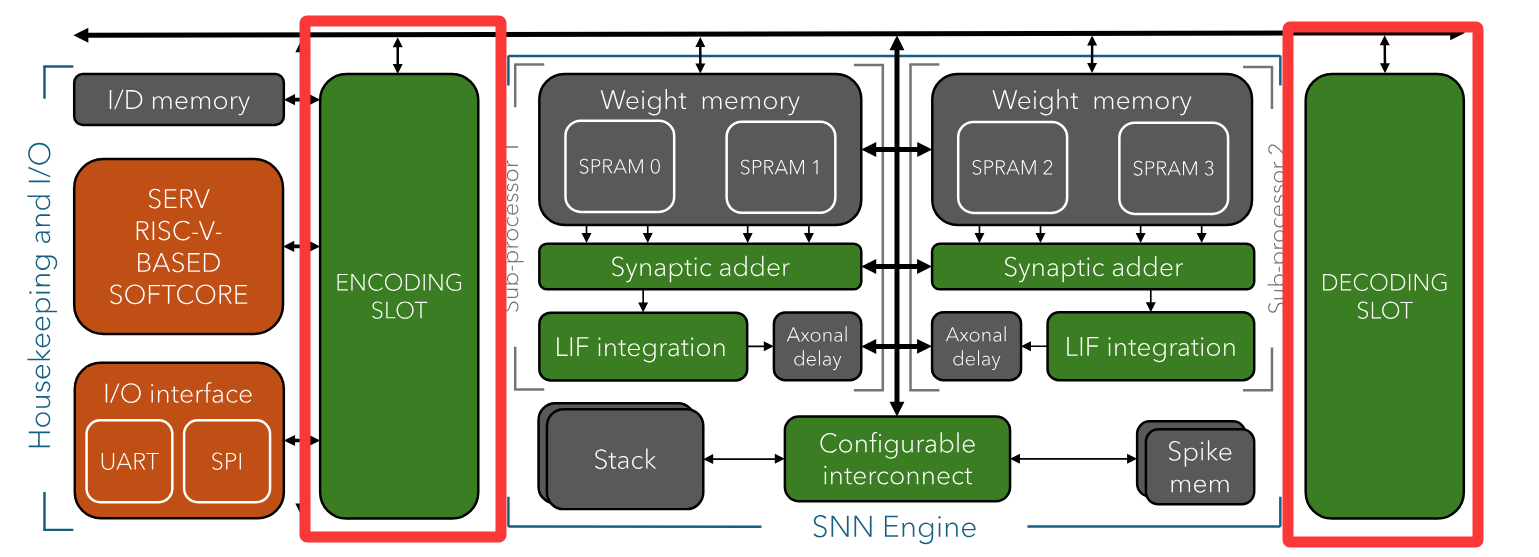
SYNtzulu的编码槽可以被定制,以实现多种将输入数据转换为脉冲序列的方法。SNN引擎留给FPGA的资源足以实现相当复杂的DSP密集型方法,包括对大量通道数和采集速率的数据预处理。解码槽用于解释SNN引擎产生的输出脉冲序列,提供可用的输出,例如回归的结果或分类任务的结果。
编码插槽
编码插槽内部可以自由定义逻辑,但是有输入输出格式要求:
- 编码器必须从基于 BRAM 的输入缓冲器按顺序接收特征样本,一拍一个特征值。
- 编码器以脉冲组形式输出,并同拍给出组有效与组活跃标记:前者让引擎把该组脉冲存入脉冲存储,后者让引擎判断该组是否参与计算。
解码插槽
解码插槽的设计本质上比编码插槽简单,在某些情况下可能根本不需要。
例如,在回归任务中,解码是不必要的,因为网络最后一层的神经元电位直接作为输出。
而在分类任务中就必须做脉冲计数:在一个时间窗口内统计最后一层每个神经元发放的脉冲数,再用比较树选出获胜者(划一个时间窗,数一下每个神经元发了多少脉冲,谁多就是谁)。
RISC-V(SERV)核
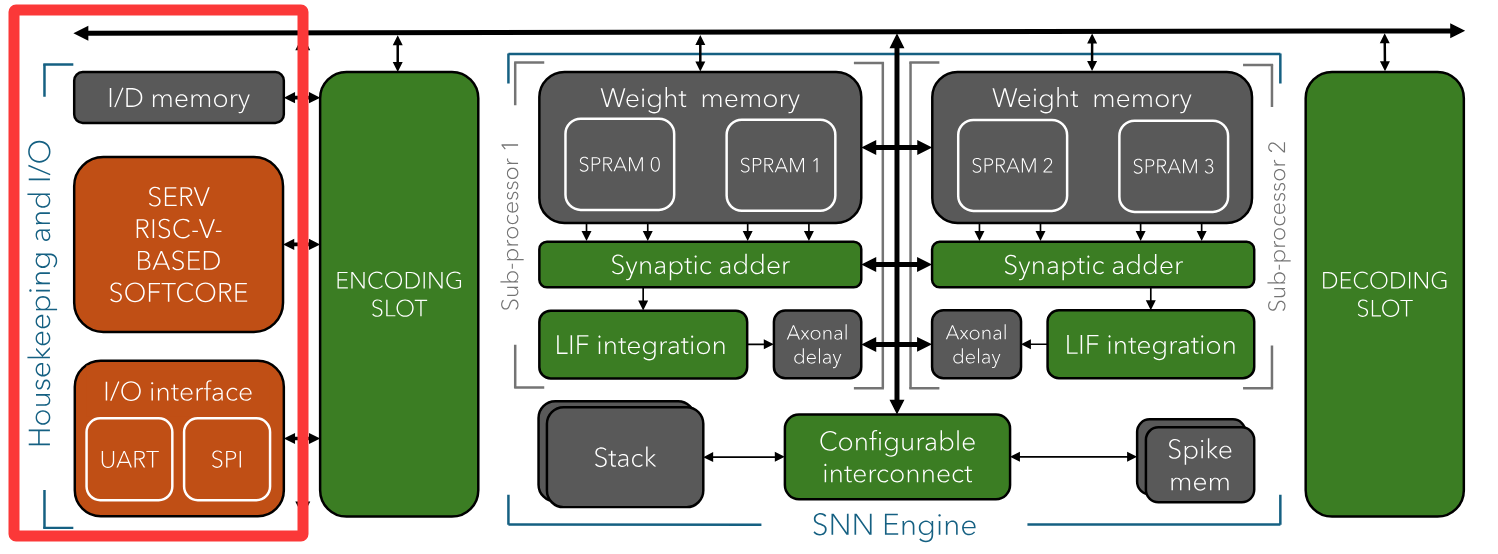
该系统嵌入了一个串行RISC-V(SERV)核,其特点是采用位串行设计,每32个时钟周期才能执行单个操作,虽然慢,但占用资源少、能耗极低,所以 SERV 不参与 SNN 推理或信号处理,只做控制。
引入 SERV 核的优势:
- SPI 和 UART 数据调度
- 权重加载(上电一次):RISC-V 只负责控制运行策略,随后由 SPI 主控把四层权重从 flash 搬进引擎的权重存储;软核只轮询完成标志,不经手数据。
- 样本输入(每帧):同理,SERV核每 5 ms 置一次启动位,16 字节采样数据被自动搬进输入缓冲器。demo 中这份数据来自 flash(模拟传感器),实际部署时来自挂在该 SPI 上的传感器。
- 结果输出(每帧):推理完成后,软核从输出缓冲读出 32 字节——末层神经元的 16 位膜电位,逐字节喂给 UART。这是三条通路中唯一需要 CPU 反复搬运的环节。
- 电源管理
- 两次采样之间,数据在等下一帧,引擎早已算完。所以软核在输出完成后做两件事——置位门控寄存器,直接关掉 24 MHz 主振荡器,
- 此时只有 10 kHz 的低频振荡器在驱动定时器;到点后产生异步中断,清掉门控位、主振荡器重启,软核醒来后开始下一轮采样。
- 这让平均功耗从推理时的 12.05 mW 降到 1.45–9.87 mW(视应用而定),而门控逻辑本身只占 25 个 LC。
- 编码与解码槽的参数配置
- 编码阈值、解码参数等架构超参数由软核在运行时写入寄存器,换任务时不必重新综合硬件;
- 因此同一套编码/解码插槽逻辑可以复用到不同任务上,灵活性来自"可配置"而不是"可重写"。
相关概念
编码种类
编码种类围绕下面四点来组合:
- 基于帧:把一段连续输入数据先收集成一帧(时间窗口),等窗口收集完成之后,统一执行脉冲编码。(攒满时间窗口之后才开始编码)
- 基于事件:不需要积攒时间窗口。每一个输入采样点到来就对应一个时间步,逐采样即时判断处理;只有输入信号触发特定事件(幅值越限 / 变化超过阈值),才输出脉冲。(采样来了立刻判断,不是一定输出脉冲)
- 速率编码:依靠一段时间窗口内脉冲的总数量表征信号大小;必须在一段窗口里统计,因此天然依附于基于帧的处理范式,不能像事件式编码那样逐采样即时输出。
- 时间编码:依靠脉冲发生的时刻(时间位置)承载信号信息(需要分情况讨论)。
基于帧的速率编码(frame‑based rate encoding)
基于帧的速率编码是基于帧处理范式 + 速率编码信息表达方式组合而成的脉冲编码方式。
- 处理流程:先持续采集一段连续输入信号,缓存攒满预设的时间窗口(帧);窗口收集完毕后统一执行编码。
- 信息表达:输入信号的大小由该时间窗口内产生的脉冲密度(脉冲总数量)表征。脉冲出现的时刻、脉冲之间的先后顺序不用于表达原始信号强弱。只要窗口内脉冲总数相同(即密度相同),就代表同等大小的输入。
- 特点:
- 必须依赖时间窗口,无法用于基于事件的处理范式;
- 每个输入神经元独立统计自身在窗口内的脉冲数目;
- 编码层面不关心脉冲什么时候发放,只统计计数。
- 局限:存在等于窗口长度的固有延迟;丢失信号内部精细时序信息。
- 数据流:原始传感器数值 → 缓存攒满一帧 → 统计信号幅值映射为窗口脉冲数量 → 生成脉冲序列送入 SNN 做推理。
基于帧的时间编码(frame‑based temporal encoding,典型为 TTFS,Time-To-First-Spike)
基于帧的时间编码是基于帧处理范式 + 时间编码信息表达方式组合而成的脉冲编码方式。
- 处理流程:持续采集输入信号并缓存,攒满预设时间窗口(帧),窗口结束后开始编码,生成分布于窗口时长内的脉冲序列。
- 信息表达:输入信号强弱由每个输入神经元在本窗口内自身第一个脉冲的发生时刻表征。该神经元首个脉冲出现得越早,信号幅值越大;同一神经元后续产生的脉冲不再用来代表原始输入的大小。
- 特点:
- 依赖固定时间窗口,存在窗口带来的固有延迟;
- 各输入神经元相互独立,各自记录自己在窗口内的首脉冲时刻,不是全局窗口最早的脉冲;
- 从编码语义上,仅首脉冲承载幅值信息,后续脉冲可忽略(硬件层面若不做抑制,后续脉冲仍会输入 SNN 参与运算)。
- 局限:需要等待窗口结束获取信息;仅利用首脉冲时刻,对波形内部动态时序信息利用有限。
- 数据流:原始传感器数值 → 缓存攒满一帧 → 根据信号幅值确定各神经元首脉冲产生时刻,生成脉冲序列 → 送入 SNN 推理。
纯基于事件的时间编码(pure event‑based temporal encoding)
基于事件的时间编码是基于事件处理范式 + 时间编码信息表达方式组合而成的脉冲编码方式。
- 处理流程:持续接收传感器采样点,每一个输入采样点到达即对应一个时间步,逐样本即时判断处理,无需积攒时间窗口;当输入信号满足预设事件触发条件(信号变化幅度超过阈值 / 信号绝对幅值越过自适应阈值),立刻输出脉冲;不满足条件则不产生脉冲。新采样持续不断到来,编码判断持续进行,不存在窗口的采集 - 编码分阶段阻塞,也没有窗口流水线机制。
- 信息表达:依靠脉冲发生时刻、脉冲之间的相对时间间隔以及完整脉冲时序序列共同表征原始信号动态。不存在 TTFS 里首脉冲优先级更高的规则,所有生成的脉冲均为有效信息;同时,长时间无脉冲的平稳时段本身也携带信号信息。
- 特点:
- 不需要固定时间窗口,消除了窗口采集带来的固有延迟;
- 采样点逐个实时判断,脉冲按需即时产生,不是一次性批量生成一整段脉冲序列;
- 两种触发模式:Delta 调制依靠相邻采样的变动幅度触发脉冲;iEEG 编码依靠信号绝对幅值越过自适应阈值触发脉冲。
- 局限:生成的脉冲流稀疏且脉冲分布不稳定,对后端 SNN 引擎的时序处理能力有要求;硬件实现上对实时阈值判断模块有需求。
- 数据流:原始传感器数值 → 逐采样实时判断(编码槽)→ 满足事件条件即时输出脉冲 → 脉冲逐个送入 SNN 推理。
脉冲稀疏性
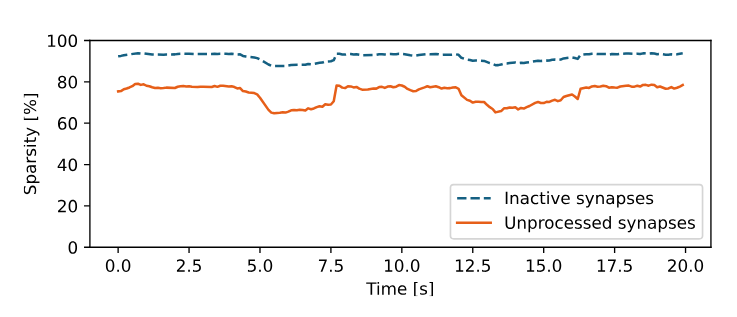
脉冲稀疏性:由于每一层神经元的输出,会出现大面积为 0 的情况,所以输出的脉冲有着明显的稀疏性质。
见下图: