反向传播
我在多层感知机笔记中提到,感知机的学习规则只适用于单层网络,一旦引入隐藏层,隐藏层神经元的参数该调整多少就无从得知。反向传播(Backpropagation)就是解决这个问题的方法。谦行AIing老师的视频讲解非常好,这里十分推荐。
在学习反向传播前建议先理清几个后面会反复出现的关键概念。
一次训练的总体流程
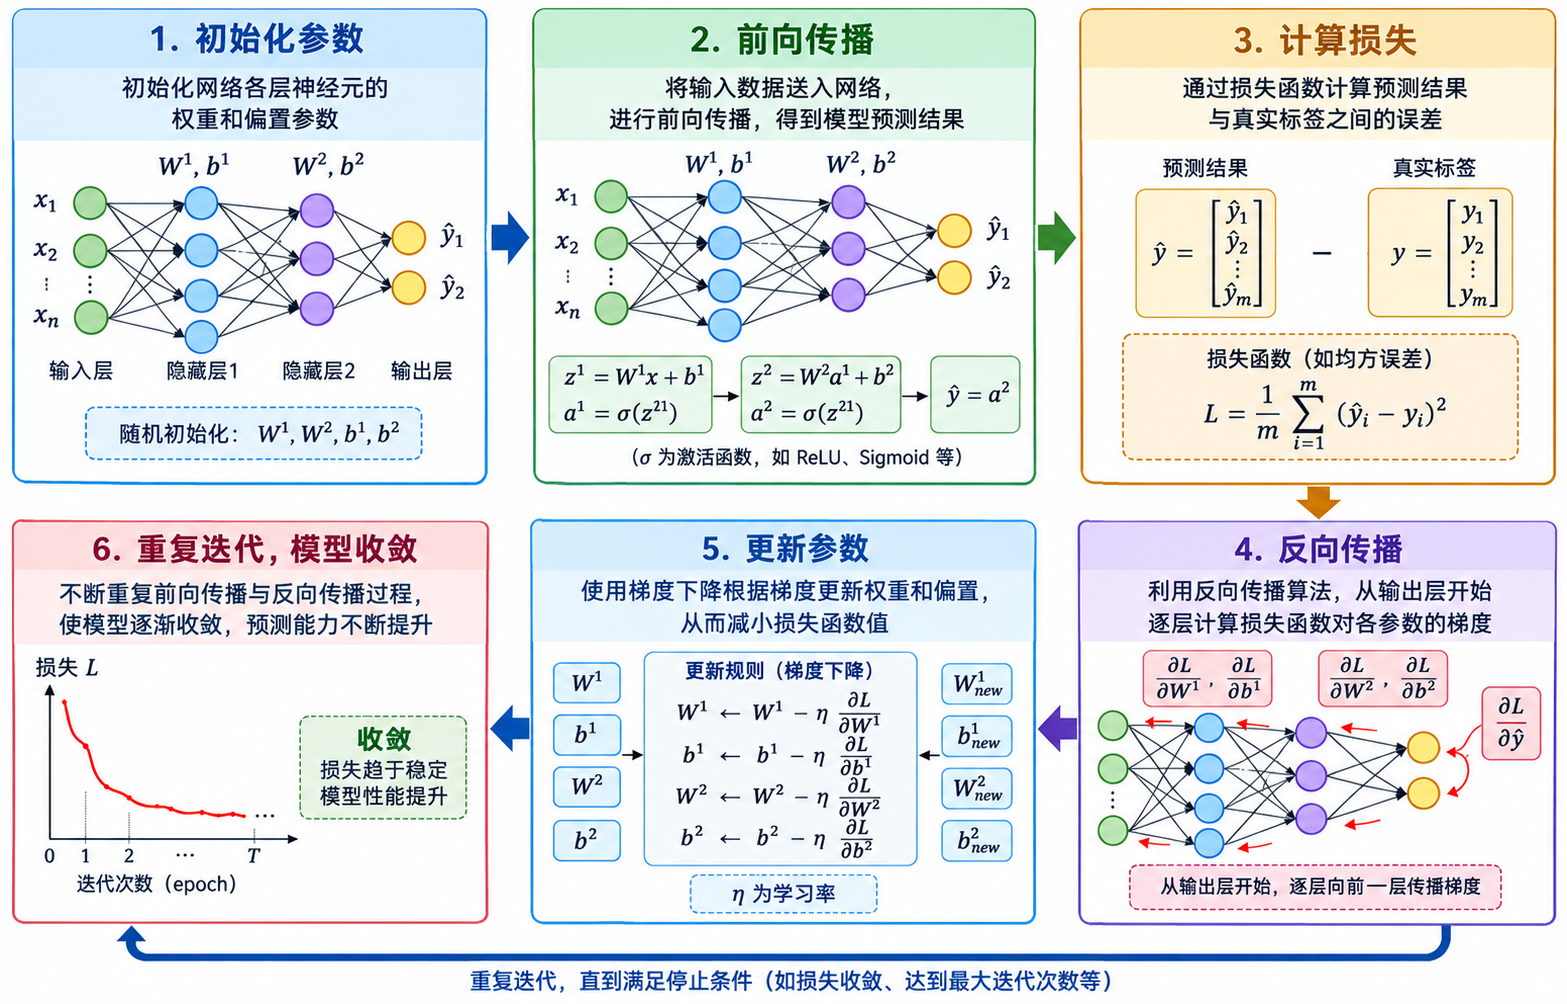
初始化参数
首先随机初始化所有权重 W 和偏置 b。
- 权重不能全部取 0,也不能全部取成同一个值:那样同一层的每个神经元接收到的输入、算出的输出、得到的梯度都完全一样,无论训练多久都学不出不同的特征(对称性问题)。
- 常见做法是取接近 0 的小随机数,并按该层的输入维度做缩放(如 Xavier 初始化、配合 ReLU 的 He 初始化),避免信号在一开始就被放大或衰减得太厉害。
- 偏置通常直接初始化为 0 即可。
同时还要定好学习率 η、迭代轮数等超参数。
前向传播
从输入层开始,沿着 l = 1, 2, …, L 逐层往后算:
- 第 l 层的净输入:z(l) = W(l)a(l−1) + b(l)
- 第 l 层的输出:a(l) = σ(z(l))
- 输入层 a(0) = x,最后一层的输出就是预测值 ŷ = a(L)
这一步不更新任何参数,只是把输入一路算到预测值。每一层的 z 和 a 都要先存下来,反向计算梯度时会直接复用这些数。
计算损失函数
把预测值 ŷ 和真实标签 y 代入损失函数,得到一个标量 L,用来衡量这次预测有多差:
- 回归任务:均方误差
L = ½ ‖ŷ − y‖² - 二分类任务:Sigmoid 输出 + 交叉熵
L = −[y·log ŷ + (1−y)·log(1−ŷ)] - 多分类任务:Softmax 输出 + 交叉熵
L = −Σᵢ yᵢ·log ŷᵢ
反向传播求的是"L 对每个参数的变化率",所以损失函数必须可导。这也是为什么要用 Sigmoid、ReLU 这类激活函数,而不是感知机里的阶跃函数——后者处处导数为 0、在 0 处还不可导,梯度根本传不下去。
反向传播
这一步的目标是求出所有参数的梯度 ∂L/∂W(l) 和 ∂L/∂b(l)。
做法是从输出层开始,把误差往输入层方向逐层回传:先算输出层该为误差负多少责任,再把这个责任按权重大小分摊给前一层,如此一直推到第一层。每到一层,就顺手记下该层参数的梯度。
更新参数
拿到梯度后,让每个参数沿梯度的反方向走一小步:
|
|
η 是学习率,控制每一步走多大:太小收敛慢,太大容易在最优附近来回震荡甚至发散。
到了这里,一次完整的训练迭代就走完了。之后回到前向传播反复循环,直到损失降到足够低或达到设定的轮数。实际的训练通常还会把训练数据切成小批量(mini-batch)分批送入,用批内样本梯度的平均值来更新。
总结与引入反向传播
回头看这一轮:初始化参数 → 前向传播 → 计算损失 → 反向传播 → 更新参数。
这几步里,除了反向传播,其余四步都是直观的计算:初始化只是给一组初值,前向传播是一层层代入公式,损失函数是把预测值和真实值套进一个公式得到一个数,更新参数则是把梯度乘上学习率减掉。它们都不需要额外的技巧。
现在仅缺少每个参数需要调整的梯度的计算方法,反向传播就是用来解决这个问题的。
误差虽然只在输出层显现,但它正是沿着刚才前向传播那条路一层层传过来才形成的。既然如此,只要沿着同一条路倒着走回去,就能把误差再传回去,从而得到每个参数的梯度。
反向传播的原理
反向传播就是通过计算每个权重对结果的影响大小来进行权重更新的,也就是权重对错误结果的贡献越大,调整幅度就要越大。这个"影响大小"在数学上就是损失函数对每个参数的偏导数(梯度)。
具体做法仍是从输出层开始往输入层回传:先算出损失对最后一层输出的梯度,再逐层往前推,每到一层就把该层参数的梯度 ∂L/∂W(l) 和 ∂L/∂b(l) 记下来。
链式法则
反向传播能成立,靠的就是链式求导法则。
对一条标量链 L ← a ← z ← w,想知道 w 变一点会让 L 变多少,就把三段的导数连乘起来:
|
|
代入该神经元:z = wx + b,a = σ(z),L = ½(y − a)2:
|
|
三层连乘正好对应"损失函数 → 激活函数 → 加权求和"这条路径,网络更深时这条链只是更长,本质不变。
把网络看成计算图时,每个节点在反向时只做两件事:接收上游传回来的梯度,乘上自己这个运算的局部导数,再往下传:
- 加法节点(z = wx + b):上游梯度原样分给各条支路;
- 乘法节点(w 乘 x):对 w 的梯度 = 上游梯度 × x,对 x 的梯度 = 上游梯度 × w,两者只是交换乘数;
- 激活节点(a = σ(z)):上游梯度 × σ’(z)。
对于多层网络,损失L需要对每一层的每一个权重参数 w 进行求导,看似计算冗杂,但大部分导数属于局部导数,可以并行计算:如每个神经元的∂a/∂z,∂z/∂w,∂z/∂x(x为前层某个神经元传入的值)等均不依赖损失L,仅有权重参数梯度∂L/∂w需要最后一层的梯度信号∂L/∂a沿计算图逐层反向传导计算得到。
举例计算
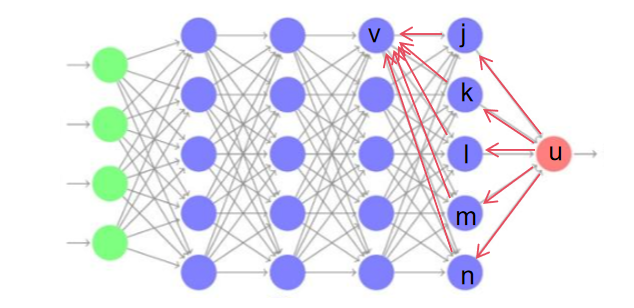
下面举例计算倒数第三层的权重梯度:
|
|
小结
- 反向传播求的是损失对每个参数的梯度,贡献越大的参数调整幅度越大;
- 一轮完整的流程是:初始化参数 → 前向传播 → 计算损失 → 反向传播 → 更新参数,然后反复循环;
- 反向传播的数学基础是链式法则,梯度沿计算图从后往前传,每个节点只需乘上自己的局部导数;
- 反向传播只负责算出梯度,真正改变参数的是梯度下降那一步。