关键概念
这篇整理几个后面会反复出现的名词:前向传播、激活函数、损失函数、梯度下降、学习率。它们不是某个具体模型,而是所有神经网络训练时都要用到的共同零件。
一个神经网络的训练过程,本质上就是这五样东西的配合:先前向传播算出预测值,用损失函数衡量它和正确答案差多少,再靠梯度下降把参数往误差减小的方向挪一点,每次挪多大由学习率决定;而激活函数决定了每一层的输出长什么样,也决定了整个网络能不能表达非线性。
前向传播
数据从输入层进入,沿着网络逐层往后算,直到输出层给出预测值,这个过程就叫前向传播(Forward Propagation)。(简单理解就是将上一层的输出作为下一层的输入,并计算下一层的输出,一直到运算到输出层为止。)
沿用多层感知机笔记的记号,i 表示层号:
- 第 i 层的净输入:z(i) = W(i)a(i−1) + b(i)
- 第 i 层的输出:a(i) = σ(z(i))
- 输入层 a(0) = x,最后一层的输出就是预测值 ŷ
需要强调两点:
- 前向传播不更新任何参数,它只是拿着当前这组参数做一次预测,看结果怎么样;
- 但每一层的 z 和 a 必须保存下来,因为反向传播算梯度时要直接复用这些中间结果,重算一遍代价太大。
激活函数
激活函数套在每一层"加权求和之后、往下传递之前",负责把 z(i) 变成该层的输出 a(i)。
它最重要的作用是引入非线性。如果去掉激活函数、每层只做线性变换,那么无论堆多少层,最终都等价于一层线性模型(推导见多层感知机笔记),网络就失去了拟合复杂函数的能力。
常见选择:
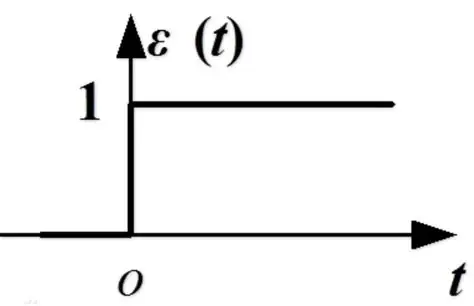
- 阶跃函数:最朴素的激活函数,感知机用的就是它;但处处导数为 0、在 0 处不可导,梯度传不下去,因此只能用于单层模型。
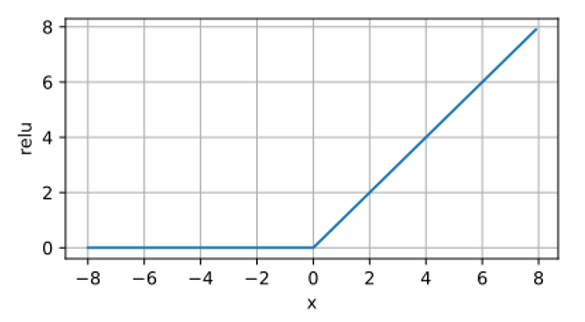
- ReLU:正区间导数为 1、负区间为 0,计算极快且不饱和,是目前隐藏层的默认选择;缺点是可能出现"死亡 ReLU"(神经元永久输出 0)。
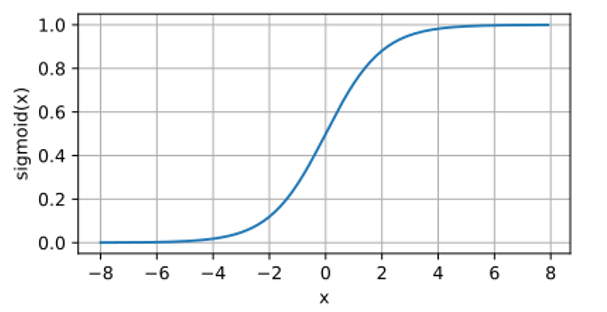
- Sigmoid:把输出压到 (0,1),适合二分类的输出层;缺点是两端饱和后梯度趋近 0,容易梯度消失,且输出非零均值。
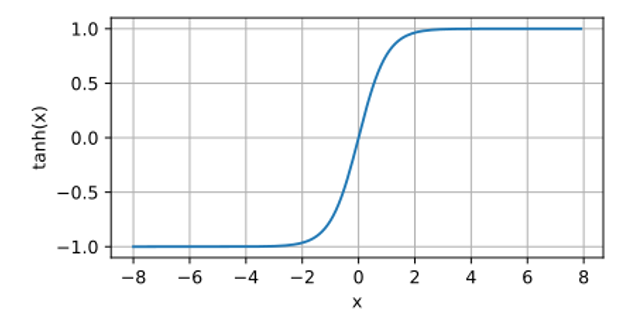
- Tanh:把输出压到 (−1,1),零均值,隐藏层比 Sigmoid 好用一些;同样存在梯度消失。
- Softmax:不属于单个神经元的激活函数,而是作用在输出层的一整组神经元上,把它们的输出归一化成总和为 1 的概率,专用于多分类的输出层。
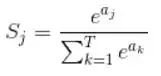
一句话总结:隐藏层默认用 ReLU,二分类输出用 Sigmoid,多分类输出用 Softmax。
损失函数
损失函数(Loss Function)用来衡量预测值 ŷ 和真实标签 y 之间的差距,输出一个标量 L 代表损失。
它是训练的目标:模型训练得好不好,就看损失能不能降下来。常见形式:
- 回归任务:均方误差
L = ½ ‖ŷ − y‖<sup>2</sup> - 二分类任务:交叉熵,配合 Sigmoid 输出使用
- 多分类任务:交叉熵,配合 Softmax 输出使用
损失函数有两个要求:一是能真实反映"错得多离谱",二是必须可导——因为后面要根据它对每个参数求偏导,参数才知道该往哪调。这也是为什么要选用 Sigmoid、ReLU 而不是阶跃函数的原因之一。
在整个训练流程里,损失函数正好卡在中间:前向传播算出 ŷ,损失函数把它变成一个可以求导的标量 L,反向传播再由这个 L 出发往回算梯度(反向传播)。
梯度下降
有了损失,接下来要让损失 L 变小。梯度(偏导数组成的向量)指向的是 L 上升最快的方向,那么每个参数的更新方向就很自然了——沿着梯度的反方向走:
|
|
这就是梯度下降(Gradient Descent),可以想象成站在山坡上蒙着眼往下山走:每次用脚探一下周围哪个方向最陡(求梯度),然后朝最陡的下坡方向迈一小步(更新参数),重复若干次就到了山谷附近。
按每次用多少样本来算梯度,分成三种:
- 批量梯度下降:用全部训练样本算一次梯度再更新,方向稳但慢;
- 随机梯度下降(SGD):每次只用一个样本,更新快但抖动大;
- 小批量梯度下降:每次用一小批样本(如 32、64 个),兼顾稳定与速度,实际最常用。
需要注意的是,梯度下降拿到的是当前点的局部信息,它不保证走到全局最低点:遇到局部极小值或鞍点都可能卡住或减速。
学习率
学习率(Learning Rate)η 就是上面公式里那个"步长",控制每次参数更新的幅度。
它是最重要也最容易调错的超参数:
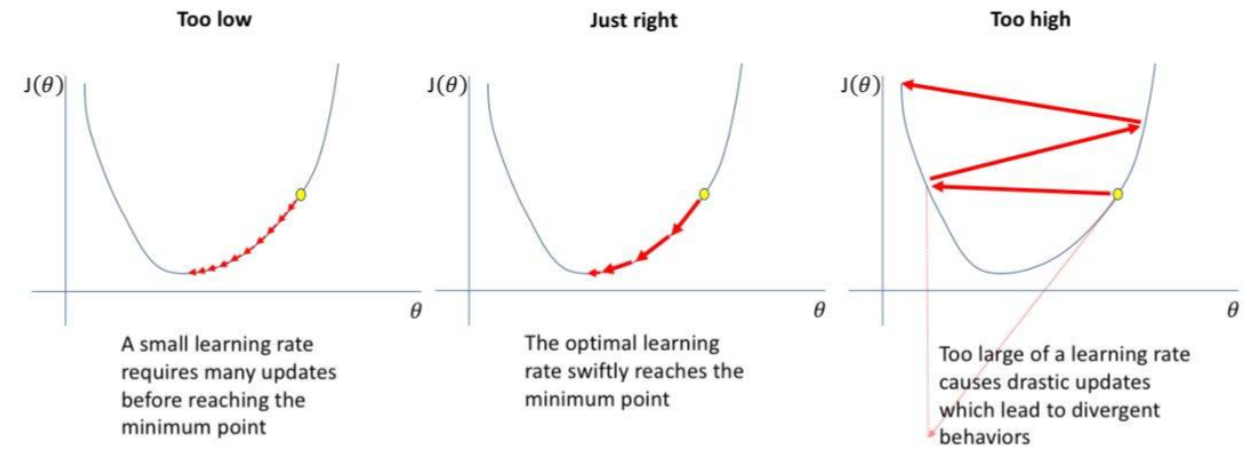
- 太大:一步跨过头,损失在最低点附近来回震荡,甚至越更新越大直接发散;
- 太小:每步都几乎没有进展,收敛极慢,还容易停在半路上;
- 比较稳妥的做法是让学习率随训练衰减:前期大步靠近,后期小步微调。也可以交给 Adam 这类自适应优化器,让每个参数各自拥有动态调整的步长。
小结
- 前向传播:拿着当前参数算出预测值,并把每层的中间结果存下来备用;
- 激活函数:给线性变换加非线性,否则多层网络等价于单层;隐藏层默认 ReLU,输出层按任务选 Sigmoid 或 Softmax;
- 损失函数:量化预测与真实的差距,必须可导,是前向与反向之间的分界点;
- 梯度下降:沿梯度反方向更新参数来减小损失,实践中多用小批量;
- 学习率:控制每一步走多大,太大发散、太慢卡住,通常随训练衰减。