多层感知机
我在感知机笔记中,记录了单层感知机,它是二分类的线性分类模型,在数据线性可分时,由 Novikoff 定理能够保证在有限步中能做到完全收敛。但无法解决 XOR 等线性不可分问题,这些问题需要多层感知机。
引入隐藏层
异或电路如下图所示:
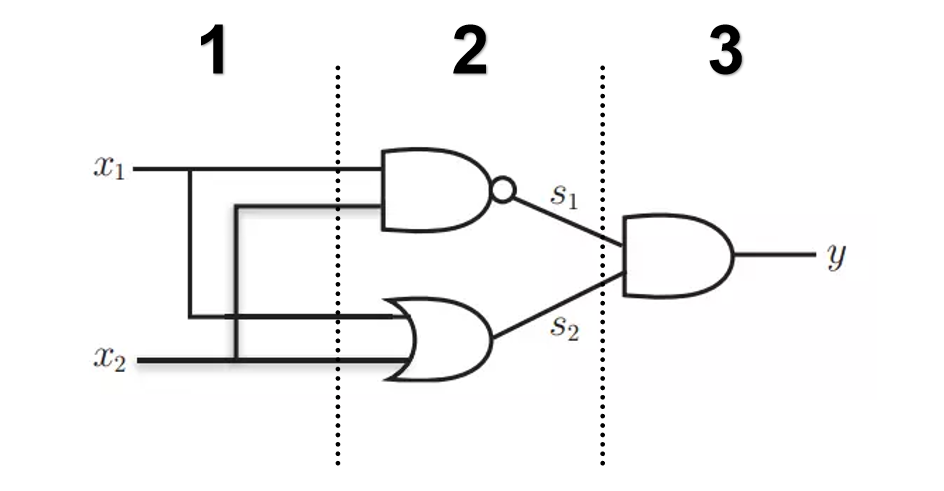
可以看到异或是由两次任务来完成:
- 在第一部分输入后,输入信号输入到第二部分进行与非和或运算。
- 完成两个运算后,同时输入到第三部分完成与的运算从而做到异或。
把它转换成感知机表示如下:
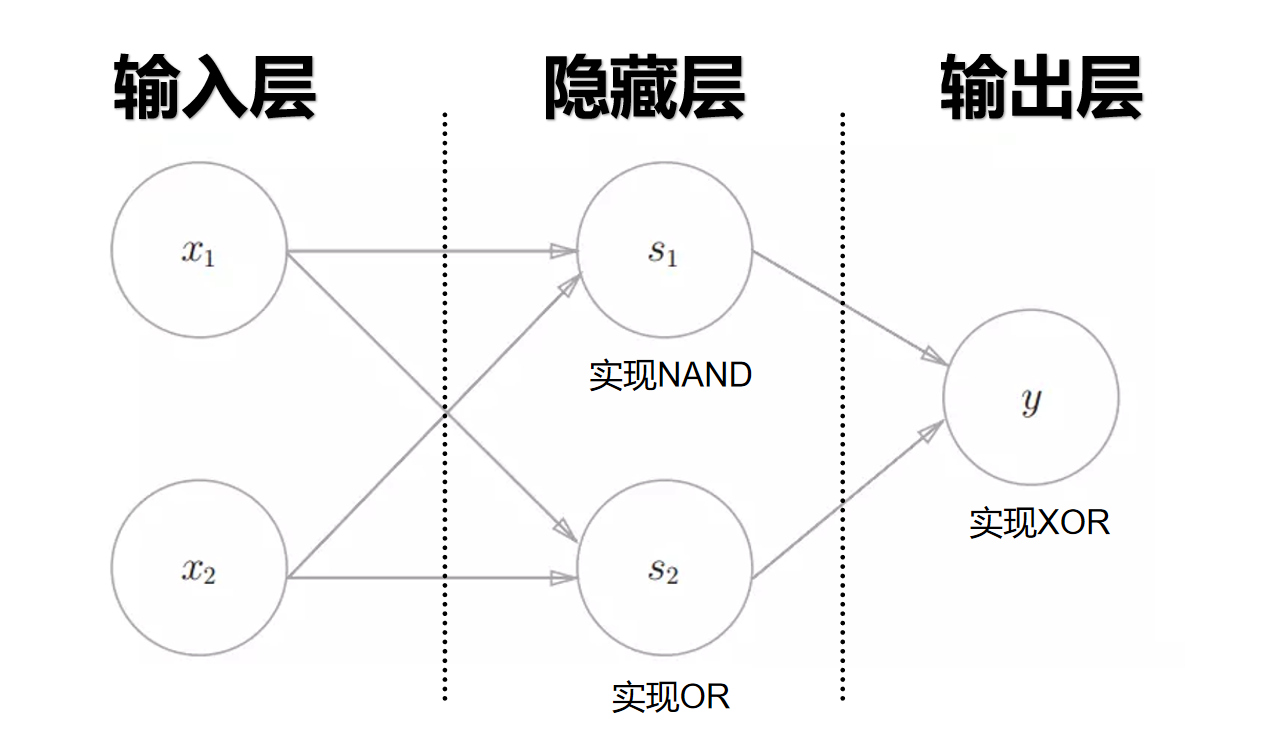
可以分析出任务的完成方式:
- 在输入层接收两个输入x1,x2。
- 在隐藏层可以做两个并行的感知机,一个做OR运算,一个做NAND运算。
- 在输出层将两个隐藏层的运算输出的结果做AND运算,从而实现异或逻辑。
通过引入隐藏层,大量感知机的组合可以完成各种各样的复杂任务
多层感知机
MLP是层级化、全连接的神经网络结构,层与层之间无跳过、无循环,相邻层神经元之间全连接(相邻层的任意两个神经元都有连接),整体分为3类核心层(输入层->隐藏层->输出层),结构如下:
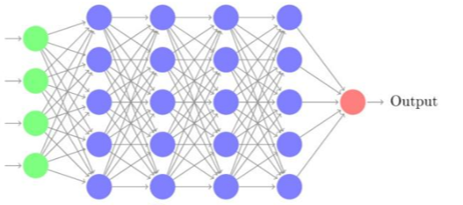
- 输入层:
- 仅负责接收原始数据/特征,不做任何计算,神经元数量 = 数据的特征维度(如输入是 28×28 的图片,展平后神经元数为784)。
- 无激活函数,仅传递数据。
- 隐藏层
- MLP 的核心层,可设置1层或多层(多层时称为深度多层感知机),层数/神经元数是关键超参数。
- 同一层神经元并行提取不同的特征或规则。
- 后续层的输入为前一层的输出,逐层进行抽象构造出更有效的特征。
- 输出层(最终预测结果,神经元数量由任务类型决定)
- 二分类任务:1个神经元(输出0/1)
- 多分类任务:神经元数 = 类别数(如MNIST手写数字分类,设10个神经元);
- 回归任务:1个神经元(输出连续值)
多层线性变换
多层感知机如果在每一层只做线性变换,那么无论多少层隐藏层,MLP 最终等价于单层线性模型。
例如:
- 第一层输出h = W1x + b1。
- 第二层输出y = W2h + b2。代入第一层输出得到y = W2(W1x + b1) + b2。
可以看出来仍然是一个一阶线性函数,所以无论堆叠多少层感知机仍然是线性模型。
引入激活函数
在每一层神经元加权求和的输出后,套一个非线性函数再输出,该非线性函数称为激活函数(Activation Function)。
单层感知机中,激活函数为阶跃函数(Step Function)如下图。
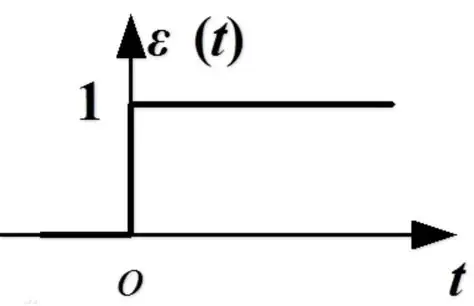
一些常用的激活函数
- ReLU(Rectified Linear Unit) ✅ 最常用 :优点:计算快、缓解梯度消失,适合隐藏层;缺点:存在“死亡ReLU”问题。
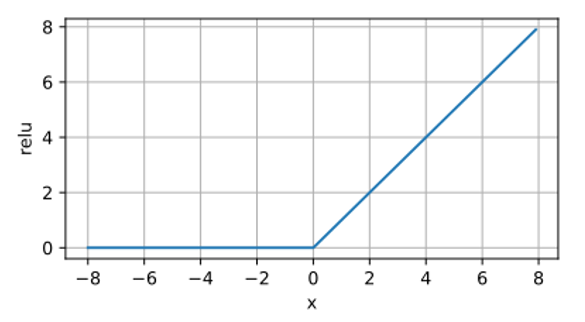
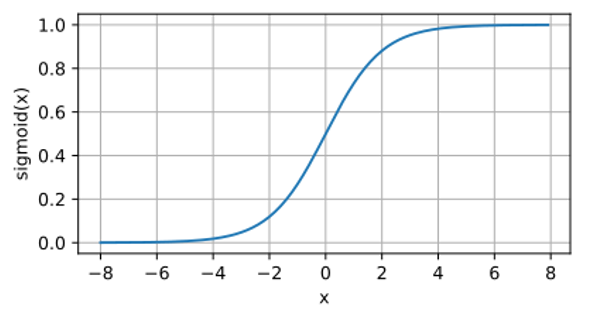
- Sigmoid:优点:输出映射到(0,1),适合二分类输出层;缺点:梯度消失、输出非零均值。
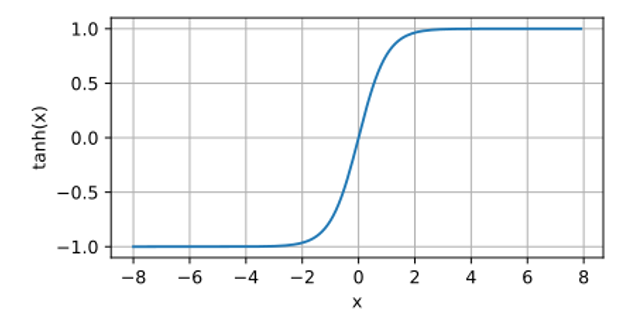
- Tanh:优点:输出映射到(-1,1),零均值;缺点:仍存在梯度消失。
- Softmax ✅ 多分类输出层专用,将多个神经元的输出归一化到(0,1),且总和为1,代表样本属于各类别的概率。
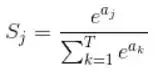
万能逼近定理
万能逼近定理(Universal Approximation Theorem, UAT):一个含有足够多神经元的单隐藏层MLP,可以以任意精度逼近任意连续函数。
- 意味着MLP在理论上具备表达任意连续函数的能力
- 但实际中,定理只保证存在这样一组参数,不保证梯度下降能学到;且所需神经元数可能随精度指数级增长。
多层感知机的数学表达
由于每一层感知机神经元的输出结果都是上一层输入的组合运算,所以最终结果在数学计算上可以用函数的嵌套来进行表示,即:
- 层函数:hi(u)= σi(Wiu + bi) (u 为上一层的输出,i 为层号)
- 输出函数:output = hn(hn-1(…h2(h1(X)))),其中 h1(X) 即输入层到第一层的结果,逐层向后传递。
多层感知机遇到的问题
- 感知机的学习规则只适用于单层网络
- 隐藏层神经元需要调整的梯度无从得知
- 下一次会写反向传播算法的笔记,反向传播算法的作用是得到各个神经元参数需要修改的梯度