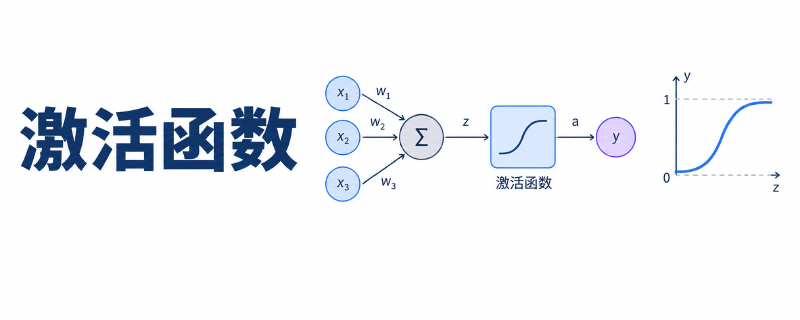
激活函数
在多层感知机笔记里,为了让网络摆脱"多层等价于单层"的困境,我们给每一层的加权求和结果套了一个非线性函数,这就是激活函数(Activation Function)。当时只是顺带介绍,这里把它单独展开整理。
一句话定位:激活函数决定了神经元"要不要被激活、以多大强度往下传",它是网络里唯一的非线性来源。
为什么必须有激活函数
如果去掉激活函数,每一层只剩线性变换:
|
|
两个矩阵相乘仍然是一个矩阵,两层网络塌缩成了一层。堆十层、一百层结果都一样,再多参数也只是在拟合一个线性模型,连异或这种简单的非线性问题都解不了。
反过来,只要每层套一个非线性函数,多层叠加就能拼出任意复杂的决策边界,这正是万能逼近定理所保证的。
所以激活函数的第一要务是:提供非线性。
为什么不采用非线性变换一步到位
为什么神经网络要先做线性变换、再套非线性激活,而不是直接采用 y = x2 + b 这类非线性变换一步到位?
- y = Wx + B(矩阵乘加 MAC)天然极适合硬件加速,在GPU中加速运算极快
- 激活函数的值一般在0附近,对于原始数据基本没有放大或缩小,y = x2 + b 这样的非线性随着层数的加深,数据会指数级膨胀,从而使计算复杂度暴涨
好激活函数的几条标准
好的激活函数除了非线性,实际用起来还会看这几项:
- 可导(至少几乎处处可导):反向传播要靠它传梯度,导数为 0 或不存在的函数直接用不了;
- 导数不能太小:梯度要能一路传回浅层,否则会出现梯度消失;
- 计算要快:每个神经元、每个样本、每次迭代都要算一遍,越简单越好;
- 输出最好是零中心:输出全是正数时,后续权重的梯度会同号,更新方向被"锁死"成同向锯齿;
- 梯度良好:不要出现梯度消失或梯度爆炸,最好接近1;
- 单调 / 平滑 / 有界(加分项,非必须):梯度更稳定,训练更容易收敛
这几条很难全部满足,下面每个函数都是在不同取舍之间做选择。
常见激活函数
更多激活函数可以参见这篇文章。
阶跃函数(Step Function)
|
|
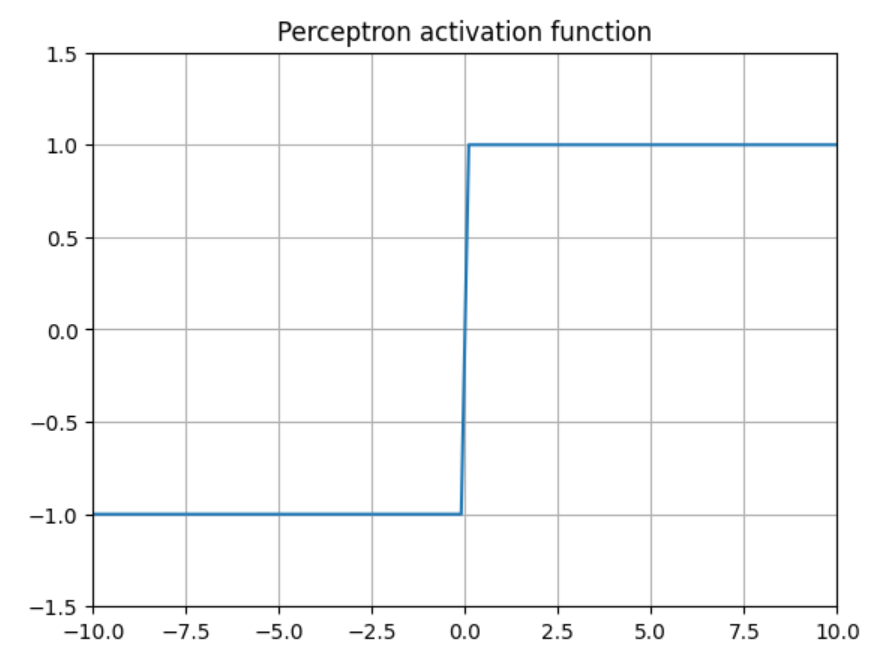
最朴素的激活函数,感知机用的就是它:加权求和加偏置后判断正负,输出 0 或 1。
问题在于它是分段常数:在 0 处不可导,其余地方导数处处为 0。梯度根本传不下去,所以只能用于单层模型——这也是感知机无法扩展到多层、必须改换成后面这些函数的原因。
Sigmoid(Logistic)
|
|
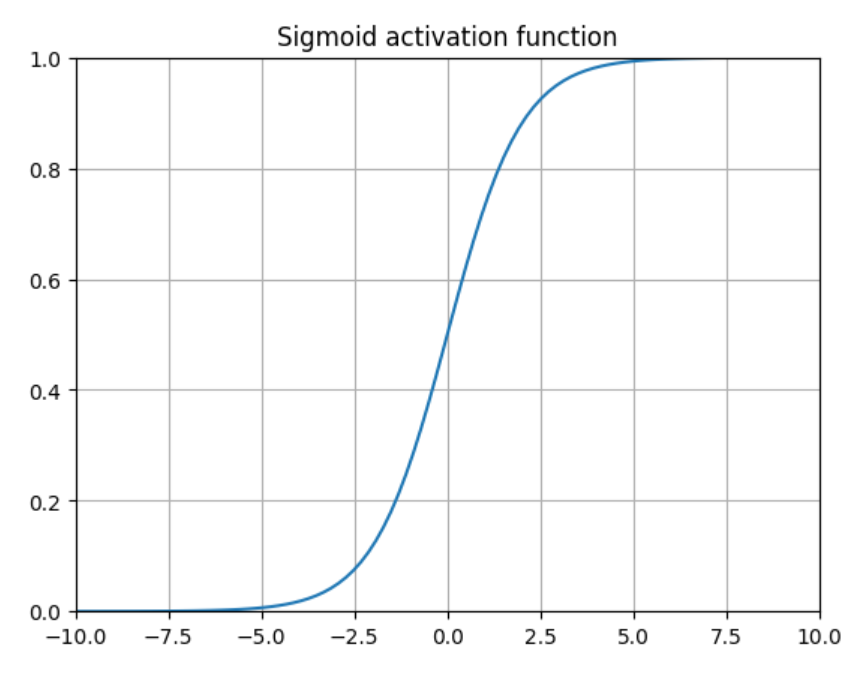
把任意实数压到 (0,1),可以当作概率来读,因此二分类任务的输出层至今仍是它的主场。
缺点也很典型:
- 两端饱和:|z| 稍大,两端曲线就压平,导数趋近 0,深层网络里梯度连乘后迅速消失;
- 输出不是零均值:输出恒为正,后面一层的输入全是同号值,权重更新方向受限,收敛变慢;
- 计算贵:指数运算比简单乘法运算慢很多。
- 梯度消失:导数最大值只有 0.25(在 z = 0 处),也就是说每往回传一层,梯度最多只剩四分之一——这是它梯度消失特别快的直接原因。
Softmax
|
|
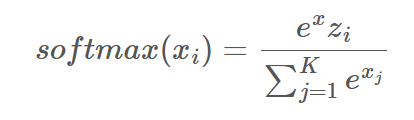
严格说它不是"单个神经元的激活函数",而是作用在输出层一整组神经元上的归一化操作:把 K 个实数映成 K 个落在 (0,1)、且总和为 1 的值,正好可以当作"属于各类别的概率"。
因此它专用于多分类的输出层,并且几乎总是与交叉熵损失搭配使用(见反向传播笔记)。
需要注意:Softmax 的输出是相互牵制的,某一个变大,其余的必然变小,所以它只适合"类别互斥"的多分类,多标签分类要对每个类别各用一个 Sigmoid。
注意:CrossEntropyLoss 内部自带 Softmax,模型最后一层不要手动写 Softmax,否则等于计算两次
Tanh(双曲正切)
|
|
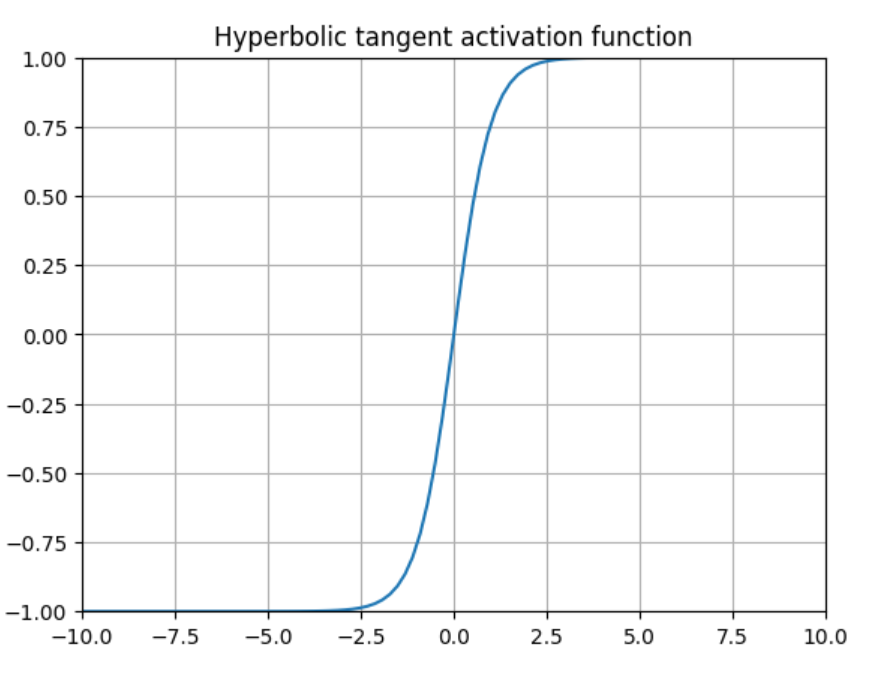
可以看成 Sigmoid 的"拉伸平移版":
- 值域从 (0,1) 变成 (−1,1),输出零中心,所以在隐藏层上比 Sigmoid 好用一些,收敛更快;
- 导数最大值为 1(在 z = 0 处),比 Sigmoid 的 0.25 大,梯度消失来得慢一些;
- 但两端同样饱和,梯度消失的问题仍然存在,深层网络依然扛不住;
- 依赖指数运算,计算成本比 ReLU 高。
ReLU(Rectified Linear Unit)
|
|
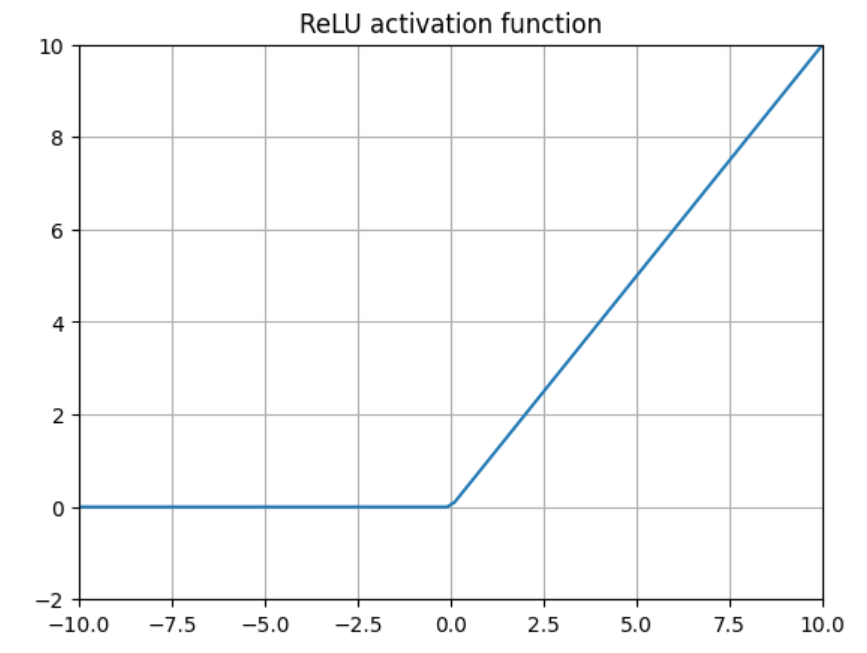
目前隐藏层的默认选择:正区间原样通过(导数恒为 1),负区间直接截断为 0。
优点:
- 计算就是一次比较,极快;
- 正区间导数恒为 1,不饱和,梯度可以无损地往回传,极大缓解了梯度消失;
- 负区间输出 0,带来一定的稀疏性。
缺点:
- 死亡 ReLU:一旦某个神经元的输入长期落在负区间,它的梯度恒为 0,参数再也不会被更新,这个神经元就"永久失效"了;学习率设得过大时尤其容易发生;
- 非0中心输出;
- 输出无上界,深层神经网络会一直放大,离不开BatchNorm归一化。
Leaky ReLU
|
|
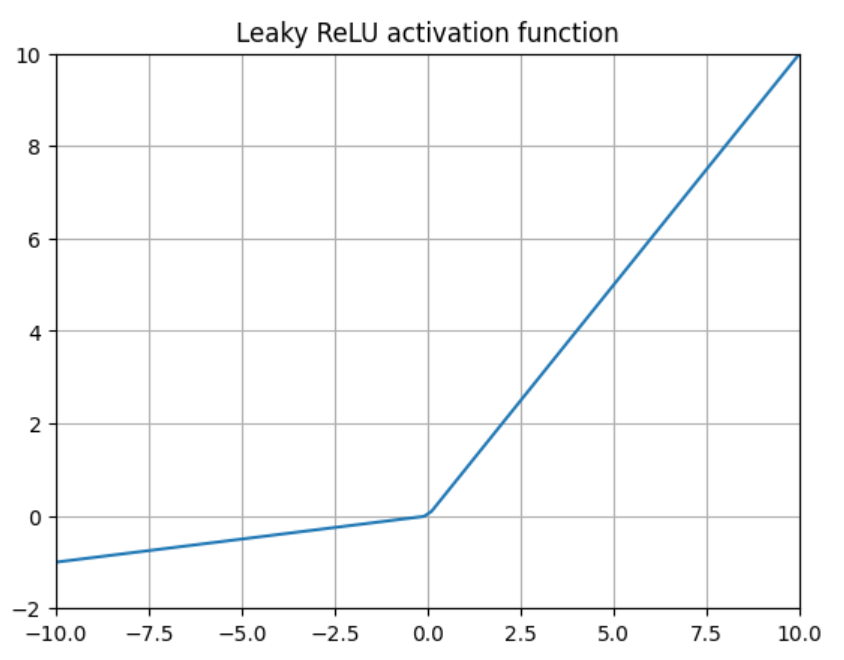
优点:
- 解决了ReLU输入值为负时神经元出现的死亡的问题
- Leaky ReLU线性、非饱和的性质,在SGD中能够快速收敛
- 计算复杂度低,不需要进行指数运算
缺点:
- 函数中的超参数α,需要通过先验知识人工赋值(一般设为0.01),不一定能调到最优
GELU
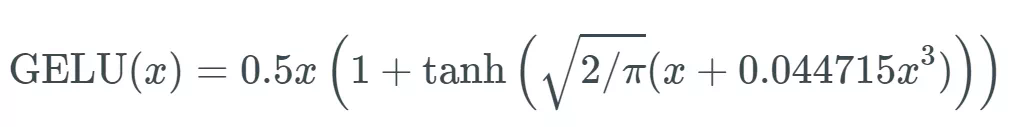
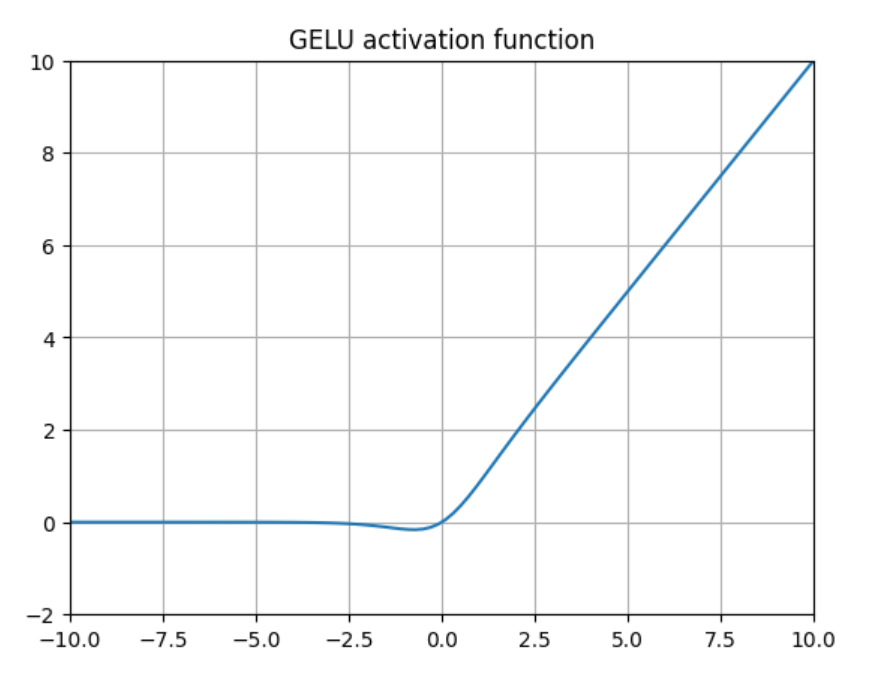
GELU 将 ReLU 在 0 处的硬性切断改成了更柔和的软门,现在GELU是transformer的标配,在 BERT、GPT、ViT 等 Transformer 中显著优于 ReLU/ELU。
SiLU/Swish
|
|
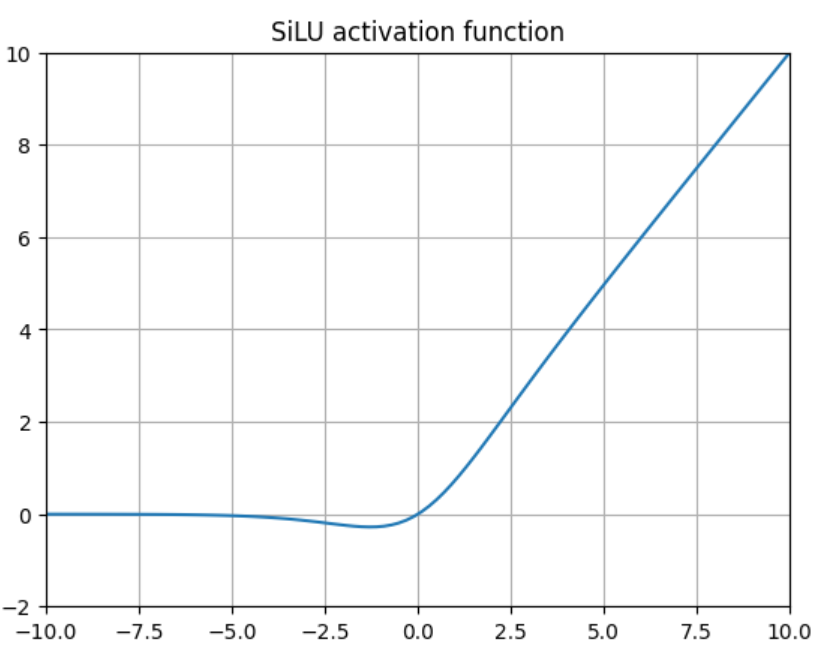
SiLU相比于GELU计算代价更轻,与GELU类似但形式更简单
在FFN中一般采用SiLU
隐藏层和输出层怎么选
这两处的诉求并不一样,选择标准要分开看:
| 位置 | 选择 | 原因 |
|---|---|---|
| 隐藏层 | ReLU(及其变体) | 计算快、不饱和,梯度好传 |
| 二分类输出层 | Sigmoid | 输出可当概率读 |
| 多分类输出层 | Softmax | 归一化成总和为 1 的概率分布 |
| 回归输出层 | 不用激活(线性输出) | 需要输出任意实数,不能限制值域 |
一句话记忆:隐藏层默认 ReLU,输出层按任务类型挑,回归则直接线性输出。
小结
- 激活函数是网络里唯一的非线性来源,没有它多层就等价于单层线性模型;
- 好的激活函数要非线性、可导、梯度好传、计算快,这几条往往互相冲突;
- 阶跃函数不可导,只能用于单层感知机;Sigmoid / Tanh 会饱和,深层容易梯度消失;
- ReLU 简单、正区间不饱和,是隐藏层的默认选择,但要留意死亡 ReLU;
- Softmax 作用在一整层上,专用于多分类输出层;回归任务的输出层不加激活函数。