梯度下降
反向传播只负责算出梯度,真正把参数改掉的,是梯度下降这一步。
在反向传播笔记里,梯度 ∂L/∂W 已经算出来了;在损失函数笔记里,L 是要被最小化的目标。梯度下降(Gradient Descent)就是拿着这些梯度去更新参数的那一环。关键概念汇总里只给了最基础的形态,这里把它完整展开。
梯度下降的理解
神经网络中,需要调整参数来使损失变小,反向传播求出的梯度,代表参数变化带来损失增长最快的方向,可以向该方向的反方向调整参数,从而使损失变小,这个方法就是梯度下降。
基本形式
|
|
- η为学习率(超参数)
- 为什么是减(梯度指向上升最快的方向,要沿反方向走)
- 几何直觉——蒙眼下山的比喻(蒙着眼站在一座损失函数构成的山上,梯度指向上山(损失变大)最陡的方向;想要下山、快速降低损失,就往梯度的反方向走。每次只走一小步(学习率控制步长);步子太大,容易跨过谷底,甚至来回震荡、无法收敛。)
图解:
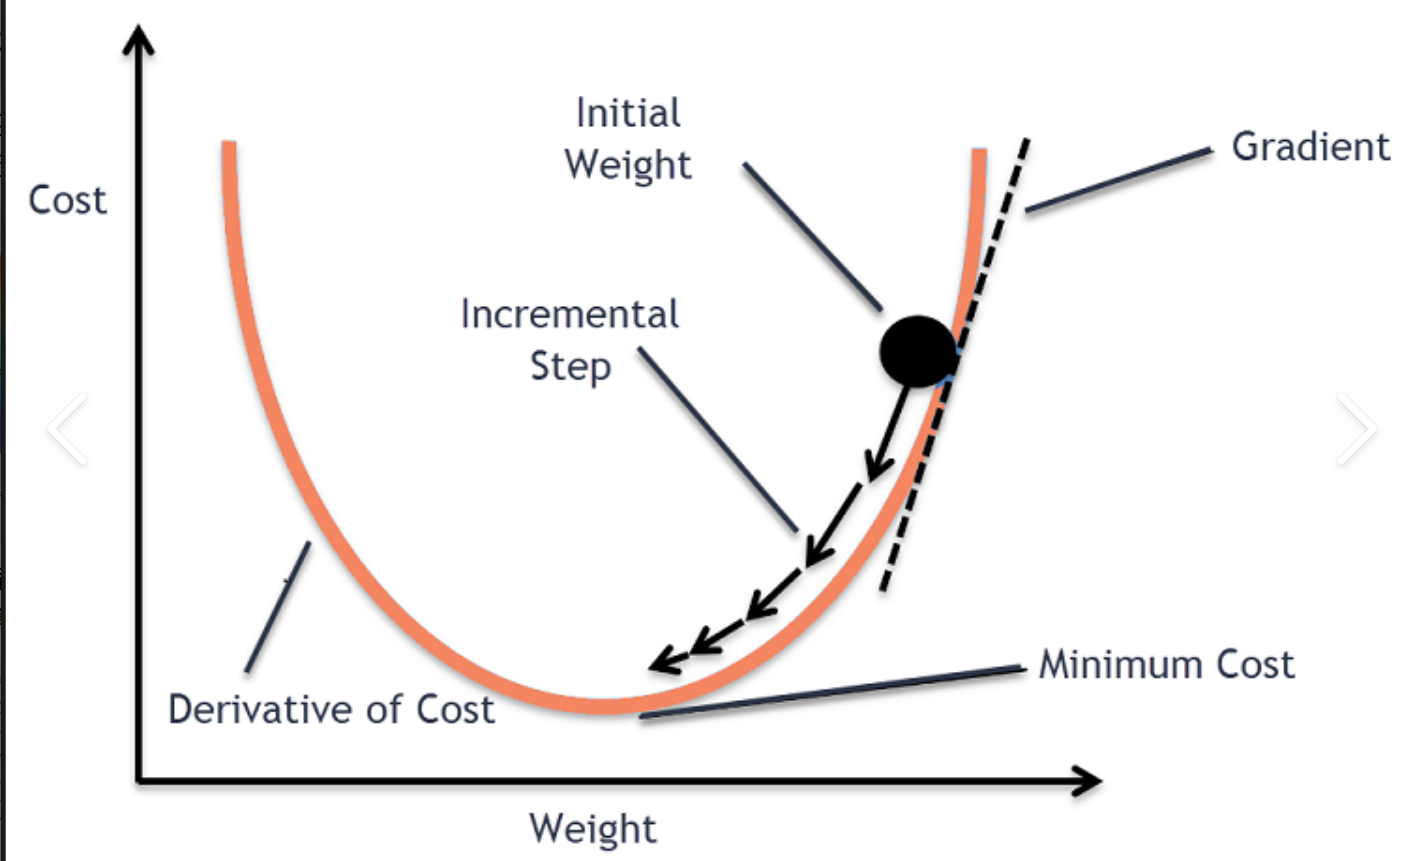
学习率设置过小以及过大带来的影响
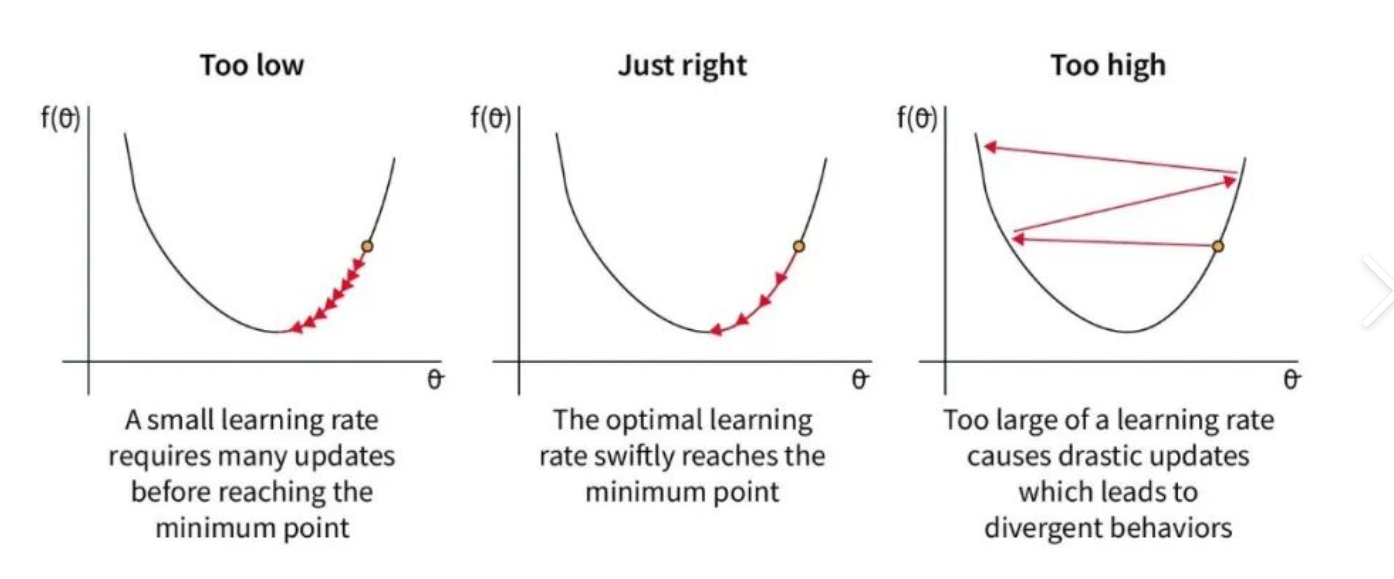
因此梯度下降可以整理为 3 个核心关键词:
- 梯度(Gradient)
函数在当前点上升最快的方向。
我们要反方向走,才能最快下降。
- 学习率(Learning Rate)
每一步走多大:
- 太大:迈过谷底、来回震荡、甚至不收敛
- 太小:走得极慢,训练半天不动
- 收敛(Convergence)
损失不再明显下降,说明走到谷底了。
梯度下降优化器
懂得了梯度下降的原理,此时面临几个问题:
- 每次更新用多少样本
- 如何改变参数(怎么避免反复横跳,和训练太慢)
- 是否要给每个参数独立的学习率
- 学习率 η 的值该不该随着训练自动调整
优化器的作用就是处理这些问题,从而使训练更快更准。
Batch GD:批量梯度下降(每次都用全部样本)
使用整个训练集的优化算法被称为批量(batch)或确定性(deterministic)梯度算法,因为它们会在一个大批量中同时处理所有样本,然后对梯度求均值后,进行参数更新。
- 优点:
-
梯度由全数据集确定,估计准确、没有噪声,收敛过程平稳;目标函数为凸时,用固定学习率就能收敛到全局最优。
-
由全数据集确定的方向能够更好地代表样本总体,从而更准确地朝向极值所在的方向。当目标函数为凸函数时,一定能收敛到全局最小值,如果目标函数非凸则收敛到局部最小值。
-
它对梯度的估计是无偏的。样例越多,标准差越低。
-
一次迭代是对所有样本进行计算,此时利用向量化进行操作,实现了并行。
- 缺点:
(1)尽管在计算过程中,使用了向量化计算,但是遍历全部样本仍需要大量时间,尤其是当数据集很大时(几百万甚至上亿),就有点力不从心了。
(2)有可能停留在:局部极小值/鞍点(梯度 = 0,但是有的方向损失上升、有的方向下降。它既不是极大,也不是极小。)/平坦的区域(梯度接近 0,曲面很平缓,不是严格意义上的极小点,只是坡度很小训练不动)
SGD:随机梯度下降(随机抽一个样本就更新一次)
随机梯度下降法不同于批量梯度下降,随机梯度下降是在每次迭代时使用一个样本来对参数进行更新。
- 优点:
-
由于不是在全部训练数据上的损失函数,而是在每轮迭代中,随机优化某一条训练数据上的损失函数,这样每一轮参数的更新速度大大加快。
-
单样本梯度带有天然噪声,反而能帮模型跳出鞍点和浅层的最小值。
-
数据可以一条一条送入,支持在线学习,边收入边更新。
- 缺点:
-
单样本方差大,不收敛,在最小值附近波动。
-
单个样本并不能代表全体样本的趋势,可能有离群点干扰参数更新。
-
固定学习率可能一直震荡,需要衰减学习率。
Mini-batch SGD:小批量随机梯度下降
对BGD和SGD进行折中,每次抽出一小部分样本来训练
- 优点
- 方差明显降低,噪声更少。
- 对GPU友好,batch内部可以并行前向反向计算。
- 保留了适度的随机性,帮模型跳出鞍点。
现在的SGD调用默认使用Mini-batch SGD,它在统计效率和计算效率之间找到了均衡点。
总结
| 方式 | 每次用的样本 | 梯度噪声 | 速度 | 特点 |
|---|---|---|---|---|
| BGD | 全部 | 无 | 最慢 | 方向最准,大数据集下几乎不可用,容易卡在鞍点 / 平坦区 |
| SGD | 1 个 | 最大 | 最快 | 噪声能跳出鞍点,但会在最小值附近波动,需要衰减学习率 |
| Mini-batch | 一小批(32 / 64 …) | 适中 | 快 | 方差小、对 GPU 友好、保留适度随机性,是现在的默认选择 |
batch size 怎么取:
- 太小:梯度噪声大、收敛抖动,GPU 并行也吃不饱;
- 太大:每步更稳更快,但显存吃紧,噪声过小反而容易陷在鞍点 / 平坦区,泛化往往变差;
- 工程上的常见做法:在显存允许范围内取尽量大的 batch,同时等比例放大学习率(linear scaling rule)。
其他常见改进
Momentum
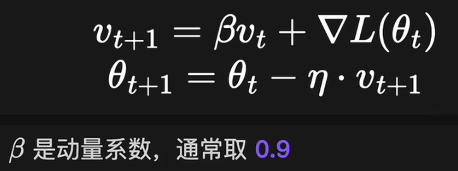
引入了惯性,下图示例:
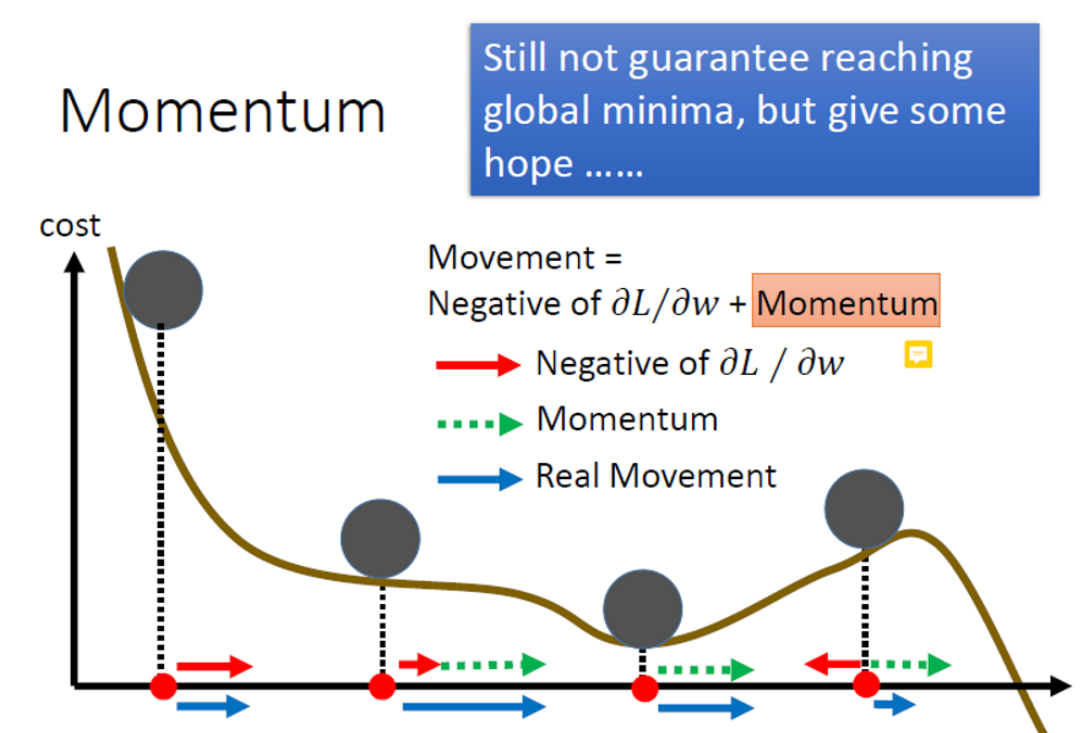
以下山为例,若无惯性,小球下山会落到第三个位置,不再往上走,引入惯性之后,小球可以凭借惯性冲上小陡坡,摆脱这个局部的最低点,从而落入更深的谷底。
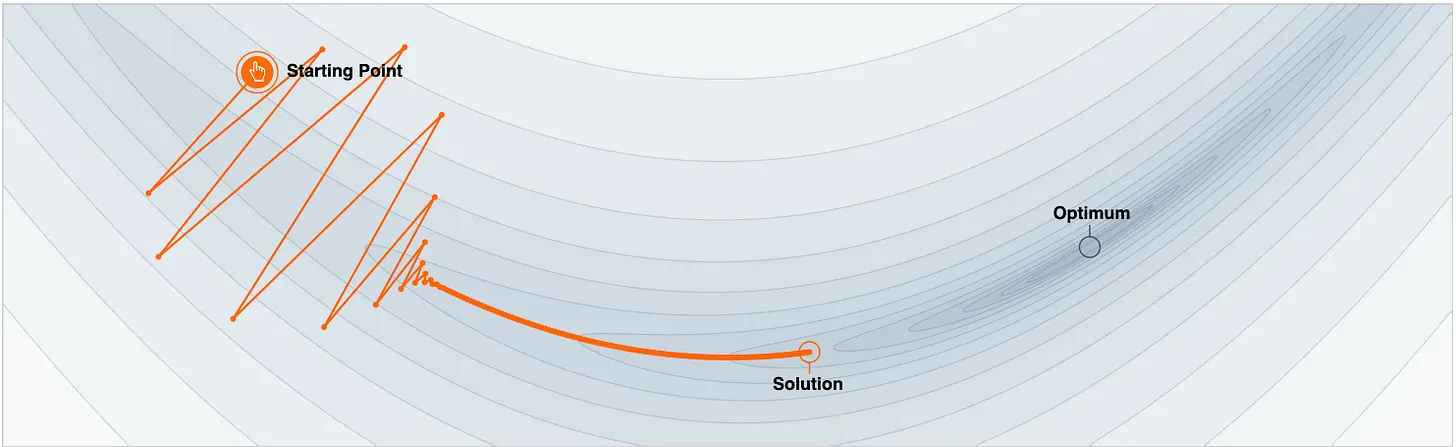
其次,梯度下降逼近最优点的时候会有不必要的左右震荡,如下图:
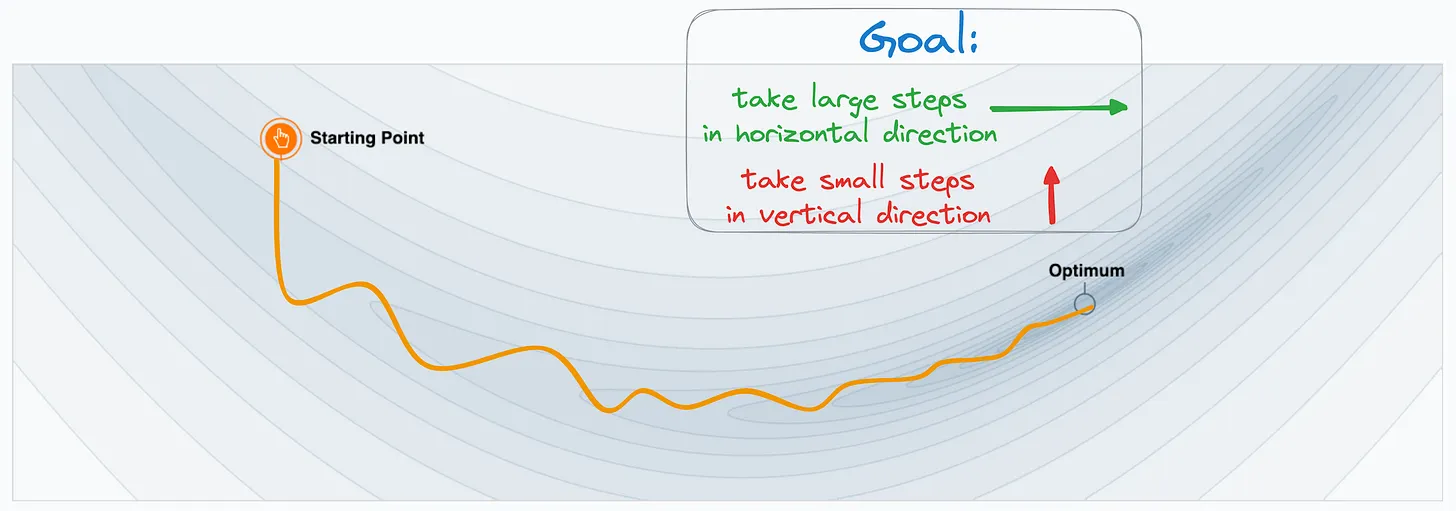
引入惯性后,能够尽量避免不必要的震荡,更好收敛到最低点,如图:
- 优点
- 累计速度,越走越快
- 抑制不必要的震荡方向
- 穿越浅鞍点与平台区
- 缺点
- 可能惯性冲过头,越过最低点,在最优点附近震荡
- 对动量系数敏感,多数情况下动量系数默认为0.9
现在的Mini-batch SGD默认都带Momentum,默认optimizer = torch.optim.SGD(momentum=0.9)。
AdaGrad:自适应学习率
不同参数的梯度量级不一样,如果使用同一个学习率更新全部参数,更新频率低、梯度量级小的参数更新效率低下。
AdaGrad的解决方法:给每个参数维护一个学习率,在训练过程中自适应调节学习率。
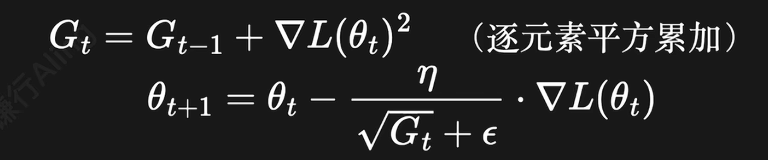
- 优点
- 不用手动调整学习率
- 适合稀疏性数据处理
- 缺点:
- 由于Gt一直累计,不减小。
- 训练越久分母越大,所以学习率会衰减到0。
- 缺少动量信息,收敛不平滑
解决方法:只保留近期梯度的影响Gt。
RMSProp
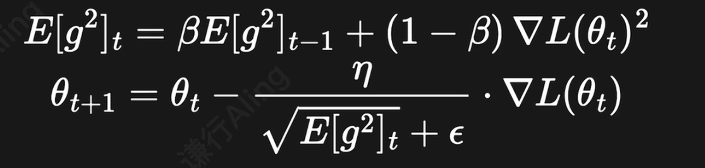
β一般取0.9。
- 优点
- 学习率不再衰减到0,滑动平均会逐渐遗忘久远的梯度
- 保留自适应学习率
- 适合非平稳的目标,因为只关注近期的梯度,所以更适应动态环境
- 缺点
- 缺少动量信息,收敛不平滑
- 多了一个超参数β,增加了调参的难度
Adam
|
|
Adam 将 AdaGrad / RMSProp 与 Momentum 结合。默认超参数为 β₁ = 0.9、β₂ = 0.999、ε = 1e-8(PyTorch 里 lr 默认 1e-3),这几个基本不用调。
- 优点
- 引入了惯性
- 自适应调整学习率
- 偏差矫正能稳定初期训练
隐藏的bug:Adam权重衰减失效(与L2正则化冲突,导致正则化失效),直到AdamW的提出,把梯度更新和权重衰减拆开。
AdamW
AdamW相对于Adam优化器的修改如下图:
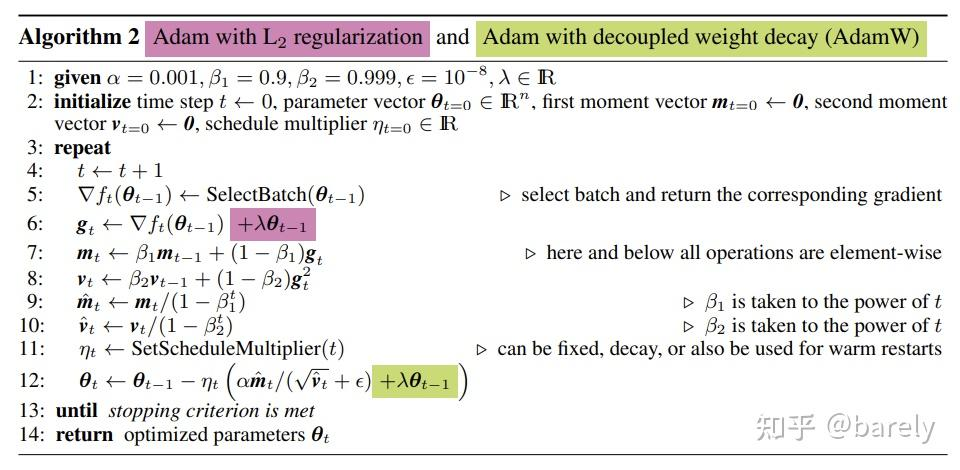
AdamW相对与Adam的改动十分简单,其将权重衰减项从梯度的计算中拿出来直接加在了最后的权重更新步骤上(图中式 12)。其提出的动机在于:原先Adam的实现中如果采用了L2权重衰减,则相应的权重衰减项会被直接加在loss里,从而导致动量的一阶与二阶滑动平均均考虑了该权重衰减项(图中式6),而这影响了Adam的优化效果,而将权重衰减与梯度的计算进行解耦能够显著提升Adam的效果。
如今见到绝大多数的都是AdamW
Muon
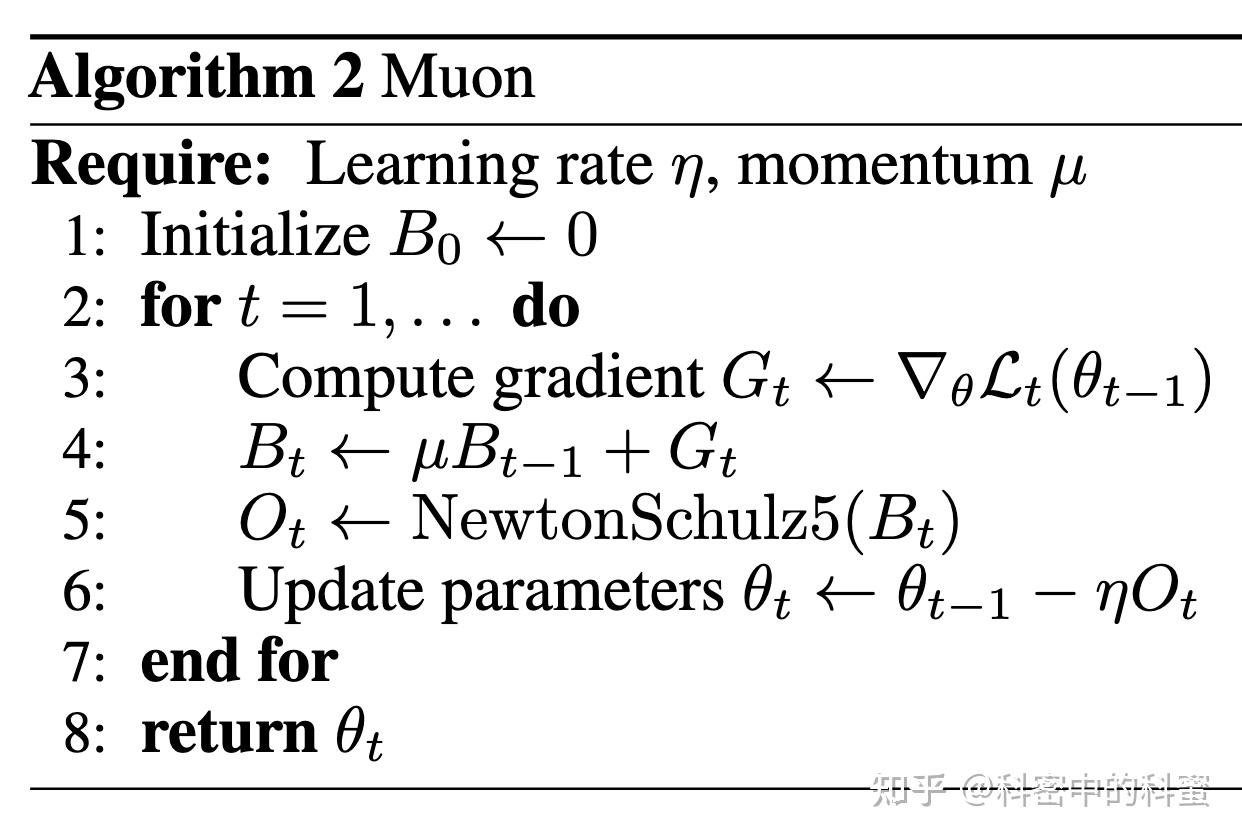
Muon优化器专门针对神经网络隐藏层的二维权重参数设计,其核心思想是在每次参数更新前,对梯度更新矩阵进行近似正交化处理,从而改善优化动力学。
Muon 的原理:利用牛顿–舒尔茨迭代高效地逼近梯度矩阵的正交化形式,并将其用于更新神经网络中的二维权重参数,从而加速训练收敛。
小结
- 梯度下降才是真正改动参数的那一环:反向传播只给出梯度 ∂L/∂W,沿梯度的反方向走一小步,损失才会往下降;
- 三个关键词:梯度(上升最快的方向,所以反着走)、学习率(步长,太大震荡发散、太小收敛不动)、收敛(损失不再明显下降);
- 实际用的是 Mini-batch:在梯度噪声与计算效率之间折中,batch size 权衡显存、速度与泛化;
- 优化器主要解决三件事:用多少样本(BGD / SGD / Mini-batch)、怎么少走弯路(Momentum 加惯性抑制震荡、冲过鞍点)、要不要给每个参数独立的学习率(AdaGrad / RMSProp 自适应,后者用滑动平均避免衰减到 0);
- Adam = Momentum + RMSProp:既有惯性又有自适应步长,偏差修正稳定了训练初期;Adam 自带的权重衰减有问题,所以实际多用解耦后的 AdamW;
- 梯度下降只有局部视野:局部极小、鞍点、平坦区、病态曲率都可能让梯度下降卡住或变慢,这正是各种改进优化器的出发点。