损失函数
损失函数(Loss Function)用来衡量预测值 ŷ 和真实标签 y (也就是实际值)之间的差距,计算输出一个标量 L 代表损失。
而“误差”:e = ŷ - y,是一个差值而不是一个独立的 “误差函数”。
在反向传播笔记里,损失 L 是整个计算图的起点:前向传播算出 ŷ,损失函数把 ŷ 和真实标签 y 的差距压成一个数,反向传播再从这个数出发往回算梯度。这里把它单独展开整理。
为什么需要损失函数
-
神经网络本身不知道自己训练推理的结果是否正确,损失函数能够量化预测误差,使神经网络知道自己的预测好不好。
-
损失函数也能为反向传播提供更新的源头,方便权重更新。
-
将人类的意图翻译给ai,做不同任务需要用不同的损失函数。
好损失函数的几条标准
- 必须可导(至少几乎处处可导):反向传播要沿它往回传梯度,这是硬要求;
- 能真实反映"错得多离谱":损失降下去的时候,最终的评价指标也要跟着变好;
- 梯度性质好:错得越离谱梯度越大,接近正确时梯度趋近 0,也就是自带"自适应步长",既学得动又不会在最优附近来回跳;
- 与输出层激活函数匹配:配错了会直接梯度消失(见后面 MSE + Sigmoid 的例子);
- 数值稳定:涉及 log 时要避免 log(0),实践上交给框架提供的融合实现(BCEWithLogitsLoss、CrossEntropyLoss),别自己先激活再算损失;
- 对离群点的态度要符合任务:离群点多的回归场景,就该选 MAE 或 Huber 而不是 MSE。
常见损失函数
均方误差损失函数 MSE
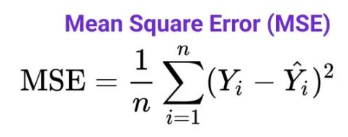
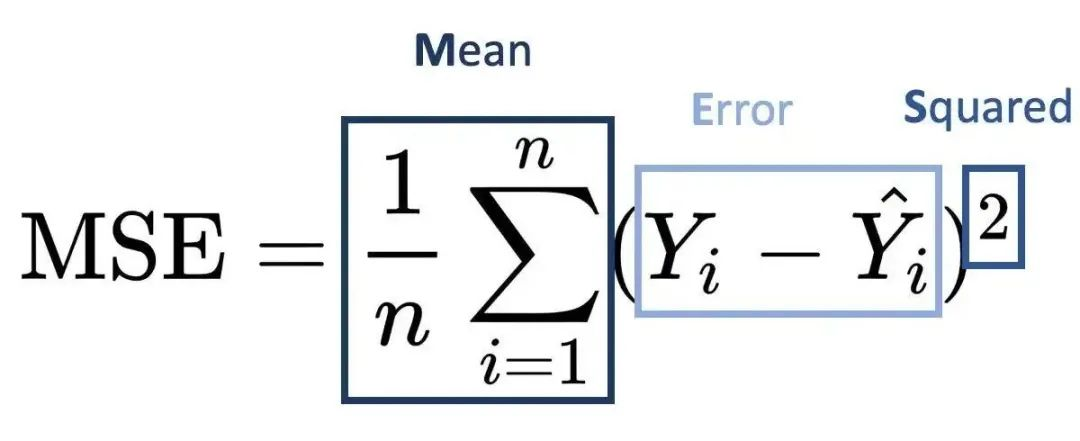
可以拆解MSE分为三部分:做差、平方、求平均
MSE的优点:
- 通过平方消除误差的正负符号,只衡量偏差大小。
- 放大误差,对于大误差惩罚更大:比如3的平方是9,对于小误差惩罚更小:比如0.3的平方是0.09
MSE的导数:
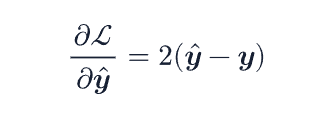
- 以误差e = ŷ - y 作为横轴变量,MSE 的梯度曲线是一个过原点的直线,离真实值越远,梯度绝对值越大,所以MSE自带一个梯度上的“自适应步长”。
MSE的局限:
- 对离群点敏感:一个出错的离群点,错误过于离谱的话,会被放大到极大,如误差为10000的话,会被放大到 10 的 8 次方,把batch梯度带偏。
- 假设目标连续可比:对类别标签无法实现,但对预测房价、预测温度这种是可以实现的,预测值要有连续性。
- 配合sigmoid会梯度消失(Sigmoid 在预测很自信时,导数趋近于 0;再乘上 MSE 的梯度项,整体梯度变得极小,参数几乎不更新,也就是梯度消失。),因此几乎不能用在分类任务上。
梯度消失:
求导:
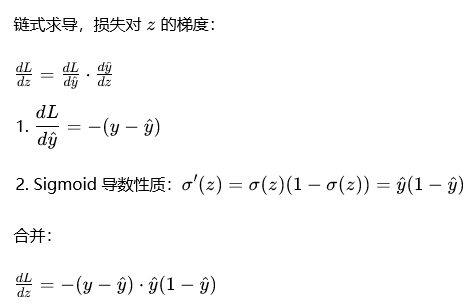
比如在二分类任务中,真实值是1,但预测值接近0,这时y - ŷ = 1,应当去给大梯度修正,但ŷ(1-ŷ)约为0。相乘后梯度约为0,梯度消失完全学不动。
MSE背后的假设
在模型输出与真实值的误差服从高斯分布的假设下,最小化均方差损失函数与极大似然估计本质上是一致的,所以MSE擅长的是集中在0附近、没有重尾的回归任务
尾部:概率分布图两端远离中心 0 的区域,就是尾部,代表出现很大误差的概率。
- 轻尾:离 0 越远,概率指数级快速下降。简单说:误差很大的样本非常罕见,几乎没有极端异常点。
- 重尾:尾部衰减很慢,时不时会冒出很大的误差(离群点 outlier)。比如学生 t 分布、帕累托分布,哪怕偏离均值很远,依然有不小概率出现。
因此在这个假设能被满足的场景中(比如回归),均方差损失是一个很好的损失函数选择;当这个假设没能被满足的场景中(比如分类),均方差损失不是一个好的选择。
平均绝对误差 MAE
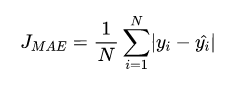
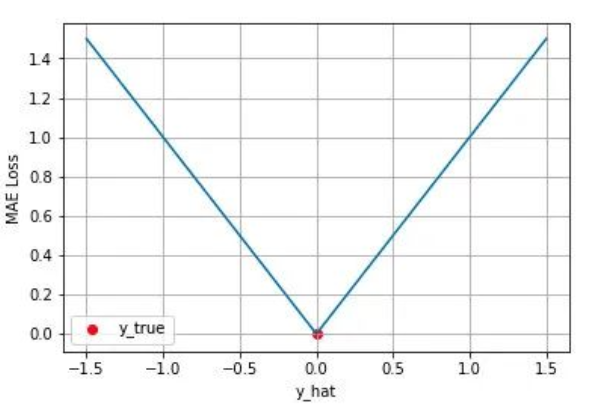
与MSE的区别:
- MSE 通常比 MAE 可以更快地收敛,因为 MAE 梯度固定为±1,MSE 的梯度会随误差大小变化
- 正因为 MAE 的梯度固定为 ±1,它不会随误差大小被放大:离群点的梯度不会像 MSE 那样被平方放大成巨值,也就不会把整个 batch 的梯度带偏,因此 MAE 对离群点更鲁棒。代价是接近最优时步长不收缩,收敛末期不如 MSE 容易微调。
Huber Loss / Smooth L1
|
|
Huber Loss 则是一种将 MSE 与 MAE 结合起来,取两者优点的损失函数,也被称作 Smooth Mean Absolute Error Loss。就是在误差接近 0 时使用 MSE,误差较大时使用 MAE。
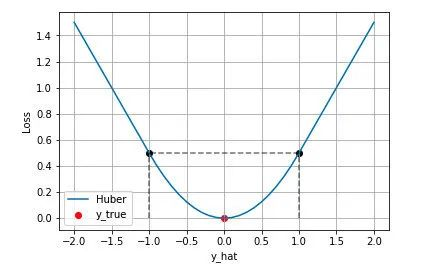
适用场景:回归,兼顾 MSE 与 MAE
- Huber Loss 结合了 MSE 和 MAE 损失,在误差接近 0 时使用 MSE,使损失函数可导并且梯度更加稳定;
- 在误差较大时使用 MAE 可以降低 outlier 的影响,使训练对 outlier 更加健壮。
- 缺点是需要额外地设置一个超参数 δ 。
交叉熵 CE
交叉熵的表达式是 L = −Σᵢ yᵢ · log ŷᵢ,其中 yᵢ 是 one-hot 标签,ŷᵢ 是模型输出的概率。利用 one-hot 的性质,求和会坍缩,只剩真实类别对应的 −log(ŷᵢ) 一项。
二元交叉熵 BCE(Binary Cross-Entropy)
|
|
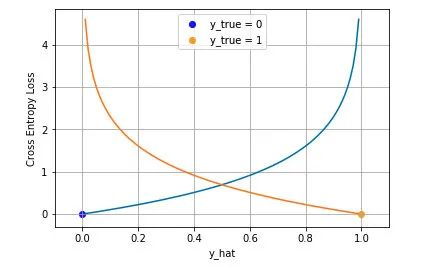
适用场景:二分类,搭配 Sigmoid 输出层;多标签分类时对每个类别各算一次
BCE + Sigmoid
求导:
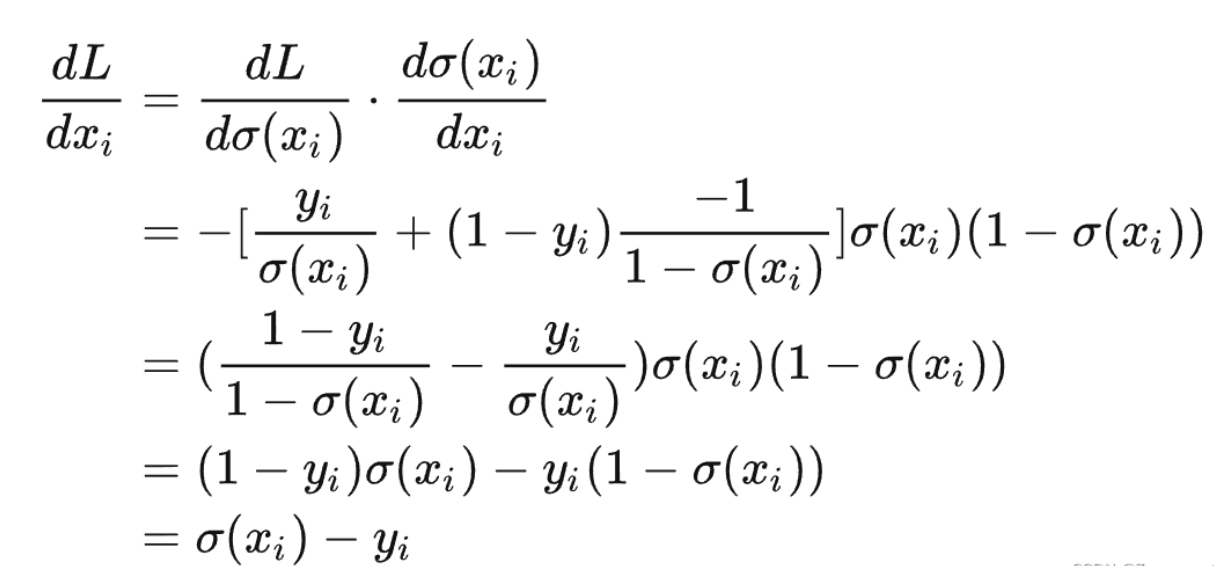
求导后发现梯度就是 ŷ − y,简单好算。
多类交叉熵 Cross-Entropy
|
|
适用场景:多分类,搭配 Softmax 输出层
使用方法解析:
-
softmax可以将网络最后一层原始输出 z(Logits,未经过激活函数激活)转化成每项非负合为一的分布。
-
套入到CE中,求和坍缩到正确类。
举例分析:
- 3分类任务,z为[2.0,1.0,0.1],one-hot标签为[1,0,0]
- softmax处理后转化为:[0.66,0.24,0.10]。
- 套入CE中:L = -1log(0.66)-0log(0.24)-0*log(0.10)=-log(0.66)=0.42。
反传到原始输出Logits的导数:
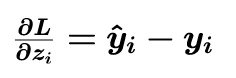
为预测值减真实值,简单易算。
其他
- Quantile Loss:在实际应用中非常有用的回归算法,通常的回归算法是拟合目标值的期望或者中位数,而分位数回归可以通过给定不同的分位点,拟合目标值的不同分位数。
- Hinge Loss:
L = max(0, 1 − y·ŷ),另外一种二分类损失函数,适用于 maximum-margin 的分类(标签取 ±1)
输出层激活与损失函数怎么搭配
这两处必须成对选择,配错了梯度会很难算甚至训不动:
| 任务类型 | 输出层激活 | 损失函数 |
|---|---|---|
| 回归 | 无(线性输出) | MSE / MAE / Huber |
| 二分类 | Sigmoid | 二元交叉熵 BCE |
| 多分类(类别互斥) | Softmax | 多类交叉熵 |
| 多标签分类 | 每个类别各一个 Sigmoid | 逐类别的 BCE |
|
|
小结
- 损失函数把"预测得准不准"压成一个可求导的标量 L,它既是训练的目标,也是反向传播的起点;
- 选它要看这几条:可导、梯度性质好(错得多梯度大、接近正确梯度小)、与输出层激活匹配、数值稳定;
- 回归用 MSE / MAE / Huber:MSE 在误差服从高斯、没有重尾时最优,且自带自适应步长,但怕离群点;MAE 梯度恒为 ±1,抗离群点,代价是末期不好微调;Huber 小误差用平方、大误差用线性,两头兼顾,多一个超参数 δ;
- 分类一律用交叉熵:二分类 BCE 配 Sigmoid,多分类 CE 配 Softmax。两者反传到 logits 的梯度都恰好是"预测值 − 真实值",好算又好收敛;
- 别用 MSE 做分类:Sigmoid 在预测很自信时导数趋近 0,再乘上 MSE 的梯度项就整体趋近 0,梯度消失、完全学不动;
- 输出层激活与损失函数必须成对选:回归不加激活直接算损失,多标签分类则对每个类别各用一个 Sigmoid + BCE。